






یک تیم AppSec به طور متوسط در هر زمان هزاران یافتهی باز را مدیریت میکند. اکثر آنها امروز ارزش اصلاح ندارند. برخی از آنها هرگز ارزش اصلاح ندارند. مشکل این نیست که تیمهای امنیتی تلاش کافی ندارند؛ بلکه این است که اولویتبندی دستی مقیاسپذیر نیست و اصلاح بدون اولویتبندی، انبوهی از کارها را ایجاد میکند که سریعتر از کاهش، رشد میکنند. اولویتبندی مشکلات با هوش مصنوعی و رفع خودکار مشکلات با هوش مصنوعی، اقتصاد را تغییر میدهند. رفع آسیبپذیریهوش مصنوعی، نویز را فیلتر میکند و هزاران یافته را به تعداد انگشتشماری که واقعاً قابل بهرهبرداری، قابل دسترسی و برای کسبوکار حیاتی هستند، کاهش میدهد. AI AutoFix این یافتهها را بهطور خودکار میبندد و بدون نیاز به وصلهگذاری دستی، اصلاحات ایمن و آگاه از زمینه را مستقیماً در گردش کار توسعهدهنده ارائه میدهد. این دو، در کنار هم، پاسخ عملی به مشکل انباشت امنیتی هستند که از زمان شروع تولید یافتههای بیشتر توسط ابزارهای تحلیل استاتیک، تیمهای AppSec را آزار داده است.
این راهنما توضیح میدهد که هوش مصنوعی چگونه کار میکند، AI AutoFix در عمل چه کاری انجام میدهد، چگونگی ارتباط کاهش نویز و اصلاح خودکار آسیبپذیریو اینکه هنگام ارزیابی ابزارآلات به چه نکاتی باید توجه کرد.
مشکل انباشتگی: چرا اصلاح دستی در مقیاس بزرگ با شکست مواجه میشود
عقبماندگیهای امنیتی یک مشکل انضباطی نیستند، بلکه یک مشکل ریاضی هستند.
یک برنامه امنیتی کاربردی مدرن در حال اجرا SAST, SCA، کشف اسرار، IaC اسکن، و DAST در یک سازمان مهندسی متوسط، ماهانه دهها هزار یافته تولید میکند. هر یافته نیاز به یک انسان دارد تا آن را بخواند، شدت آن را در متن ارزیابی کند، تعیین کند که آیا در برنامه و محیط خاص قابل بهرهبرداری است یا خیر، تصمیم بگیرد که آیا ارزش رفع آن را دارد یا خیر، آن را به یک توسعهدهنده اختصاص دهد، منتظر رفع مشکل بماند و نتیجه را تأیید کند. این فرآیند زمانبر است و اکثر تیمهای امنیتی فاقد آن هستند.
نتیجه، انبوهی از اطلاعات انباشته شده است که تشدید میشود. یافتههای با شدت بالا از شش ماه پیش در کنار یافتههای متوسط از هفته گذشته قرار میگیرند. توسعهدهندگان تیکتهایی بدون هیچ راهنمای اصلاحی روشنی دریافت میکنند. تیمهای امنیتی وقت خود را صرف اولویتبندی میکنند تا اصلاح. و یافتههایی که در واقع نشاندهنده ریسک قابل سوءاستفاده هستند، آنهایی که در یک حمله واقعی اهمیت دارند، در فهرستی از هشدارهای کماهمیت دفن شدهاند که هیچکس وقت ندارد با دقت آنها را بخواند.
سه عامل باعث میشوند که حجم کارهای عقبمانده به مرور زمان بدتر شود. اول، کد تولید شده توسط هوش مصنوعی، حجم کدهای ورودی به مرحله تولید و به همراه آن، حجم یافتهها را افزایش داده است. تجزیه و تحلیل Veracode در سال 2025 نشان داد که تنها ۵۵٪ از کدهای تولید شده توسط هوش مصنوعی در بیش از ۱۰۰ مدل آزمایش شده، ایمن بودند. دوم، گسترش ابزارهای AppSec به این معنی است که یافتهها از اسکنرهای متعدد بدون هیچ دیدگاه یکپارچه و منطق اولویتبندی مشترکی به دست میآیند. سوم، اکثر ابزارهای تحلیل استاتیک برای کامل بودن تنظیم شدهاند تا پیشپردازش.cisآنها ترجیح میدهند چیزی امن را علامت بزنند تا اینکه چیزی خطرناک را از دست بدهند، که این مثبت کاذب ایجاد میکند که اعتماد توسعهدهندگان را از بین میبرد و روند اصلاح را کندتر میکند.
اولویتبندی هوش مصنوعی و اصلاح خودکار آسیبپذیری، هر سه پویایی را مستقیماً مورد توجه قرار میدهند.
کاری که هوش مصنوعی در واقع انجام میدهد
اولویتبندی هوش مصنوعی، کاربرد یادگیری ماشینی و تحلیل زمینهای برای مسئلهی یافتن اولویتبندی است. هدف آن یافتن آسیبپذیریهای بیشتر نیست؛ بلکه شناسایی این است که کدام یک از آسیبپذیریهای یافتشده، به چه ترتیبی و چرا، ارزش اقدام دارند.
نمرهدهی سنتی شدت (CVSSبرای مثال) بر اساس ویژگیهای کلی آسیبپذیری، امتیازی را اختصاص میدهد: بردار حمله، پیچیدگی، امتیازات مورد نیاز، میزان تأثیر. این روش نمیداند که آیا تابع آسیبپذیر واقعاً در برنامه شما فراخوانی میشود، آیا از طریق اینترنت قابل دسترسی است، آیا پشت احراز هویت قرار دارد یا خیر، یا اینکه آیا بر سیستمی که دادههای حساس را مدیریت میکند تأثیر میگذارد یا خیر. یک نکته حیاتی نمره CVSS روی تابعی که هرگز در محیط تولید فراخوانی نمیشود، یک ریسک بحرانی نیست؛ بلکه یک نویز است.
هوش مصنوعی در زمینهی اولویتبندی، زمینهای را اعمال میکند که CVSS نمیتواند. این زمینه موارد زیر را با هم ترکیب میکند:
- تحلیل دسترسیپذیری: تعیین اینکه آیا مسیر کد آسیبپذیر واقعاً در برنامه در حال اجرا اجرا میشود، نه اینکه فقط در پایگاه کد وجود داشته باشد. آسیبپذیری در کد مرده قابل بهرهبرداری نیست. هوش مصنوعی تفاوت را میداند.
- امتیازدهی قابلیت بهرهبرداریاستفاده از دادههای EPSS (سیستم امتیازدهی پیشبینی اکسپلویت) و تلهمتری حمله در دنیای واقعی برای ارزیابی احتمال اکسپلویت شدن یک آسیبپذیری مشخص در دنیای واقعی. هر CVE با اکسپلویت عمومی به طور فعال مورد استفاده قرار نمیگیرد. هر آسیبپذیری بدون اکسپلویت نیز ایمن نیست.
- زمینه تأثیر کسب و کاردرک اینکه کدام برنامهها، سرویسها و داراییهای داده تحت تأثیر یک یافته قرار میگیرند و وزندهی به شدت آن بر اساس آن. تزریق SQL در یک API عمومی که دادههای پرداخت را مدیریت میکند، کاملاً متفاوت از همان یافته در یک ابزار گزارشدهی داخلی بدون دسترسی خارجی است.
- فیلترینگ مثبت کاذبشناسایی یافتههایی که با یک الگوی شناختهشدهی آسیبپذیر مطابقت دارند اما در واقع در متن قابل بهرهبرداری نیستند، و حذف آنها از صف فعال قبل از اینکه توسعهدهنده آنها را ببیند.
خروجی اولویتبندی هوش مصنوعی، فهرستی کوتاهتر از همان یافتهها نیست. این فهرستی از نظر کیفی متفاوت است، فهرستی که در آن هر مورد، به جای یک احتمال نظری، نشان دهنده یک خطر واقعی، اولویتبندی شده و قابل اقدام است. تیمهایی که اولویتبندی هوش مصنوعی را اجرا میکنند، معمولاً شاهد کاهش نویز ۸۰ تا ۹۰ درصدی از خروجی خام اسکنر تا یافتههای قابل اقدام هستند.
کاری که هوش مصنوعی AutoFix واقعاً انجام میدهد
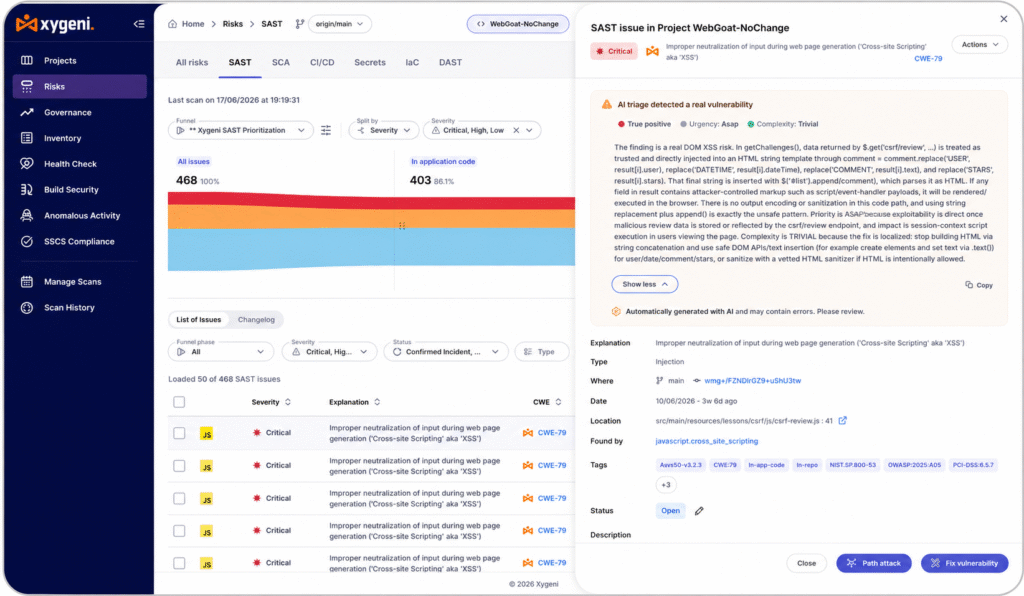
AI AutoFix بخش اصلاح معادله است. در حالی که هوش مصنوعی اولویتبندی میکند که چه چیزی را باید اصلاح کند، AI AutoFix خودش اصلاح را ایجاد میکند، یک تغییر کد ایمن و آگاه از متن که آسیبپذیری را بدون ایجاد مشکلات جدید حل میکند.
تمایز از تولید کد عمومی هوش مصنوعی در اینجا اهمیت دارد. از یک دستیار هوش مصنوعی همه منظوره خواسته میشود که یک آسیبپذیری تزریق SQL را برطرف کند، کدی تولید میکند که منطقی به نظر میرسد. AI AutoFix در یک پلتفرم امنیتی، کدی تولید میکند که در برابر الگوی آسیبپذیری خاص، زبان و چارچوب خاص مورد استفاده، قراردادهای کدنویسی خاص مخزن و زمینه ریسک خاص شناسایی شده توسط لایه اولویتبندی، اعتبارسنجی شده است. این اصلاح یک پیشنهاد نیست، بلکه یک pull request، آماده برای بررسی توسعهدهنده، به همراه آسیبپذیری برطرف شده و توضیحات رفع اشکال.
کاری که AI AutoFix در عمل انجام میدهد:
- الگوهای پرخطر را با جایگزینهای ایمن جایگزین میکند. یک کوئری پارامتری به جای الحاق رشته. یک کتابخانه deserialization امن به جای یک کتابخانه آسیبپذیر. یک تابع اعتبارسنجی ورودی به جای ورودی مستقیم کاربر در یک فراخوانی سیستم. این اصلاحیه به علت اصلی میپردازد، نه فقط علامت.
- مدیریت شکستن آگاهی از تغییر. بهروزرسانی یک وابستگی آسیبپذیر زمانی که نسخه جدید یک جایگزین موقت باشد، ساده است. اما زمانی که API تغییر کرده باشد، وابستگیهای انتقالی با هم تداخل داشته باشند یا زمانی که اصلاحیه، تستهای موجود را خراب کند، پیچیده میشود. AI AutoFix نمودار وابستگی را درک میکند و تغییرات خراب را قبل از ... علامتگذاری یا مدیریت میکند. pull request باز شده است
- اصلاحات را در محل کار توسعهدهندگان ارائه میدهد. مؤثرترین پیادهسازیهای AutoFix، رفع مشکلات سطحی در IDE را همزمان با نوشتن کد انجام میدهند. CI/CD pipeline همانطور که کد است commitتد، و در pull requests همانطور که کد بررسی میشود، نه در یک بخش امنیتی جداگانه dashboard که توسعهدهندگان هرگز آن را باز نمیکنند. اصطکاک دشمن سرعت اصلاح است.
- ترازو بدون سرشماری. یک تیم امنیتی پنج نفره نمیتواند پنج هزار یافته را به صورت دستی بررسی و اصلاح کند. AI AutoFix میتواند برای هر پنج هزار مورد، اصلاحاتی ایجاد و ارسال کند و به تیم امنیتی اجازه دهد تا به جای ایجاد هر تغییر، آن را بررسی و تأیید کنند.
کاهش نویز در عمل: از هزاران یافته تا یافتههای مهم
کاهش نویز فقط یک بهبود کیفیت زندگی نیست. این یک نتیجه امنیتی است. وقتی توسعهدهندگان هزاران هشدار دریافت میکنند، دچار خستگی از هشدار میشوند، پدیدهای که به خوبی مستند شده است و در آن حجم زیاد اعلانهای با سیگنال پایین باعث میشود انسانها خواندن دقیق آنها را متوقف کنند. خستگی از هشدار فقط باعث کند شدن روند اصلاح نمیشود. این امر باعث میشود آسیبپذیریهای واقعی از نظر دور بمانند.
کاهش نویز pipeline که هوش مصنوعی امکان رتبهبندی را فراهم میکند، در عمل به این شکل است:
A SAST اسکنر در یک مخزن اجرا میشود و ۲۴۰۰ یافته تولید میکند. بدون اولویتبندی، همه ۲۴۰۰ یافته در یک انبار قرار میگیرند. با اولویتبندی هوش مصنوعی، یافتهها بر اساس قابلیت دسترسی (حذف یافتهها در مسیرهای کد غیرقابل دسترس)، قابلیت بهرهبرداری (حذف یافتههایی که هیچ بردار حمله واقعبینانهای در شرایط فعلی ندارند)، احتمال مثبت کاذب (حذف یافتههایی که با یک الگو مطابقت دارند اما در شرایط فعلی به طور قابل اثباتی ایمن هستند) و تأثیر تجاری (رتبهبندی یافتههای باقی مانده بر اساس شدت دادهها و سیستمهایی که تحت تأثیر قرار میدهند) فیلتر میشوند. خروجی ۶۰ یافته اولویتبندی شده است، آنهایی که نشان دهنده ریسک واقعی و قابل اقدام در برنامه و محیط خاص هستند.
آن ۶۰ یافته به همراه راهنمایی برای رفع مشکل به توسعهدهندگان داده میشود. هوش مصنوعی AutoFix تولید میکند pull requests برای کسانی که رفع اشکالات خودکار واضح و ایمن دارند. تیم امنیتی بررسی و تأیید میکند. ۶۰ ریسک واقعی برطرف شدهاند. ۲۳۴۰ مورد غیرمشکل هرگز به صف توسعهدهندگان نرسیده است.
این یک بهبود جزئی در بهرهوری نیست. این تفاوت بین یک برنامه امنیتی است که مقیاسپذیر است و برنامهای که مقیاسپذیر نیست.
تجمیع ابزارها: یک عارضه جانبی که ارزش برنامهریزی دارد
یکی از مزایای کمتر مورد بحث هوش مصنوعی در زمینه اولویتبندی و هوش مصنوعی خودکار، کاری است که آنها برای گسترش بیهدف ابزار انجام میدهند.
بیشتر تیمهای AppSec چندین اسکنر اجرا میکنند: یکی برای SAST، یکی برای SCAیکی برای اسرار، یکی برای IaC، یکی برای کانتینرها، یکی برای DAST. هر اسکنر فرمت یافتهها، مقیاس شدت، نرخ مثبت کاذب و راهنمای اصلاح خود را تولید میکند، یا اصلاً هیچ راهنمای اصلاحی ندارد. تیمهای امنیتی زمان قابل توجهی را صرف تطبیق یافتهها در بین ابزارها، حذف هشدارهای تکراری که نشاندهنده مشکل اساسی یکسان هستند و ترجمه خروجی اسکنر به تیکتهای قابل خواندن برای توسعهدهنده میکنند.
پلتفرمی که اولویتبندی هوش مصنوعی را در تمام منابع جستجو با ارائه یکپارچه AutoFix ترکیب میکند، بخش عمدهای از این سربار را از بین میبرد. یافتههای حاصل از SAST, SCA، اسرار، و IaC جریان به یک موتور اولویتبندی واحد. لایه اولویتبندی منطق امتیازدهی ثابتی را در تمام منابع اعمال میکند. AutoFix بدون توجه به اینکه کدام اسکنر مشکل را شناسایی کرده است، اصلاحاتی را ایجاد میکند. توسعهدهنده یک صف، یک مقیاس شدت و یک قالب اصلاحی را میبیند.
تیم امنیتی به جای پنج پلتفرم، یک پلتفرم را مدیریت میکند. قراردادهای فروشندگان تجمیع میشوند. نگهداری یکپارچهسازی کاهش مییابد. و مدل داده یکپارچه به این معنی است که لایه اولویتبندی زمینه بیشتری دارد، یافتهای که در هر دو مورد ظاهر میشود. SAST و SCA خروجی، و همچنین از یک نقطه پایانی در معرض دید عموم قابل دسترسی است، امتیاز بالاتری نسبت به امتیازی که هر یک از اسکنرها به تنهایی به آن میدهند، دریافت میکند.
تجمیع ابزارها هدف اصلی اولویتبندی هوش مصنوعی و رفع خودکار نیست؛ بلکه کاهش حجم کارهای معوقه است. اما این نتیجهای است که به مرور زمان تشدید میشود، سربار عملیاتی را کاهش میدهد و کیفیت سیگنال اولویتبندی را بهبود میبخشد.
چگونه ابزارهای ارزیابی و رفع خودکار هوش مصنوعی (AI Triage and AutoFix Tooling) را ارزیابی کنیم؟
همه پیادهسازیهای هوش مصنوعی برای اولویتبندی مشکلات و رفع خودکار مشکلات، نتیجه یکسانی ارائه نمیدهند. اینها قابلیتهایی هستند که کاهش نویز واقعی و اصلاح خودکار آسیبپذیری را از ادعاهای بازاریابی متمایز میکنند:
- اولویتبندی مبتنی بر قابلیت دسترسی، نه فقط امتیازدهی شدت. اگر ابزار، یافتهها را صرفاً بر اساس CVSS و بدون درک اینکه آیا مسیر کد آسیبپذیر واقعاً اجرا شده است یا خیر، امتیازدهی کند، در واقع اولویتبندی هوش مصنوعی انجام نمیدهد؛ بلکه مرتبسازی انجام میدهد. از فروشندگان بهطور خاص بپرسید که قابلیت دسترسی چگونه تعیین میشود و چه منابع دادهای امتیازدهی قابلیت بهرهبرداری را اطلاع میدهند.
- همبستگی متقابل اسکنر. یک لایه اولویتبندی که فقط یافتههای یک اسکنر را میبیند، تصویر ناقصی دارد. دقیقترین اولویتبندی از مرتبط کردن یافتهها در سراسر اسکنرها حاصل میشود. SAST, SCA، اسرار، IaCو DAST، درک اینکه چه زمانی چندین ابزار، ریسک اساسی یکسانی را نشان میدهند و وزندهی مناسب به آن سیگنال.
- کیفیت و اعتبارسنجی خودکار. اصلاحیهای که آسیبپذیری جدیدی ایجاد میکند یا عملکرد موجود را مختل میکند، از عدم اصلاح بدتر است. کیفیت اصلاح را با پرسیدن این سوال که آیا AutoFix در برابر الگوهای شناختهشدهی ایمن اعتبارسنجی شده است، آیا تغییرات مخرب را مدیریت میکند و آیا شامل پوشش آزمایشی برای مسیر کد اصلاحشده است، ارزیابی کنید.
- IDE و pipeline ادغام. رفع خودکار که در یک سطح جداگانه قرار میگیرد dashboard مستلزم آن است که توسعهدهندگان گردش کار خود را برای اقدام بر روی آن ترک کنند. اصلاح با بالاترین سرعت زمانی اتفاق میافتد که اصلاحات در IDE، PR و ... موجود باشد. CI/CD pipeline، هر جایی که توسعهدهنده از قبل مشغول به کار است.
- نرخ مثبت کاذب، نه فقط نرخ مثبت واقعی. نرخ مثبت واقعی به شما میگوید که ابزار چقدر نویز میگیرد. نرخ مثبت کاذب به شما میگوید که چقدر نویز ایجاد میکند. هر دو مهم هستند و نسبت بین آنها سیگنال واقعی است. دادههای معیار را درخواست کنید، نه فقط ادعاهای بازاریابی.
- قابلیت پیگیری و لغو ممیزی. رفع خودکار در یک محصول تولیدی pipeline نیاز به مدیریت دارد. توسعهدهندگان و تیمهای امنیتی باید بتوانند اصلاحات خودکار را بررسی، تأیید، اصلاح و رد کنند، به همراه یک پیگیری کامل از آنچه تغییر کرده، چرا و توسط چه کسی.
هوش مصنوعی، اولویتبندی و رفع خودکار مشکلات با Xygeni
شیگنی رویکرد اصلاح خودکار آسیبپذیری حول یک اصل بنا شده است: تشخیص بدون اصلاح، انبوهی از مشکلات است که در انتظار وقوع هستند.
La قیف اولویتبندی Xygeni اولویتبندی هوش مصنوعی را در تمام منابع جستجو اعمال میکند (SAST, SCA، کشف اسرار، IaC, CI/CD امنیت، و DAST)، خروجی خام اسکنر را از طریق لایههای متوالی تحلیل قابلیت دسترسی، امتیازدهی قابلیت بهرهبرداری و زمینه تأثیر بر کسب و کار کاهش میدهد. خروجی، یک صف اولویتبندی شده از یافتههای واقعاً قابل اجرا است، نه یک لیست صاف از هر چیزی که اسکنر پیدا کرده است.
هوش مصنوعی AutoFix اصلاحات متناسب با متن و مختص زبان را مستقیماً به شما ارائه میدهد. pull requests، پوشش SAST یافتهها، وابستگیهای آسیبپذیر و افشای اسرار در سراسر کد نوشته شده توسط انسان و تولید شده توسط هوش مصنوعی. اطلاعات مربوط به شکستن تغییرات، بهروزرسانیهای وابستگی را که ممکن است ساخت را قبل از باز شدن PR خراب کنند، علامتگذاری میکند. توضیحات مربوط به رفع مشکلات، زمینه را برای توسعهدهندگان فراهم میکند تا تغییرات را با اطمینان بررسی و تأیید کنند، نه با اعتماد کورکورانه.
DevAI، کمکخلبان امنیتی هوش مصنوعی تعبیهشده در IDE شرکت Xygeni، نتایج اولویتبندی و پیشنهادات AutoFix را مستقیماً در محیط توسعهدهنده، همزمان با نوشتن کد، قبل از ... نمایش میدهد. commit یکپارچهسازی سرور MCP به این معنی است که دستیاران کدنویسی هوش مصنوعی میتوانند اسکنهای امنیتی را آغاز کنند، یافتههای اولویتبندیشده را دریافت کنند و بدون ترک IDE، اصلاحات ایمن را اعمال کنند.
نتیجه: تیمهایی که Xygeni را اجرا میکنند، گزارش میدهند که از هزاران یافتهی باز به یک صف اولویتبندیشده و قابل مدیریت، و از وصلهبندی دستی به اصلاح خودکار که با کدبیس به جای تعداد کارکنان، مقیاسپذیر است، حرکت میکنند. اگر حجم کارهای امنیتی شما سریعتر از آن چیزی که تیمتان بتواند به آن رسیدگی کند، در حال افزایش است، مشکل تلاش نیست. مشکل این است که ابزارهایی که استفاده میکنید برای حل آن ساخته نشدهاند.

سوالات متداول
هوش مصنوعی چقدر میتواند سر و صدای ناشی از انباشتگی اطلاعات امنیتی را کاهش دهد؟
تیمهایی که از اولویتبندی مبتنی بر دسترسی مبتنی بر هوش مصنوعی استفاده میکنند، معمولاً شاهد کاهش ۸۰ تا ۹۰ درصدی از خروجی خام اسکنر به یافتههای قابل اجرا هستند. رقم دقیق به کدبیس، تعداد اسکنرهای مورد استفاده و ویژگی مدل اولویتبندی بستگی دارد، اما تأثیر جهتدار ثابت است: اکثر یافتههای تولید شده توسط ابزارهای تحلیل ایستا در متن قابل بهرهبرداری نیستند و اولویتبندی هوش مصنوعی آنها را قبل از رسیدن به صف توسعهدهندگان شناسایی و حذف میکند.
آیا استفاده از AI AutoFix در محیطهای عملیاتی ایمن است؟ pipelines?
بله، وقتی با مدیریت مناسب پیادهسازی شود. هوش مصنوعی AutoFix همیشه باید شامل بررسی انسانی قبل از ادغام تغییرات در محصول باشد؛ ارزش آن در ایجاد خودکار اصلاح است، نه در دور زدن فرآیند بررسی. به دنبال پیادهسازیهایی باشید که شامل توضیحات اصلاح، تشخیص تغییرات مخرب و یک پیگیری حسابرسی کامل از آنچه تغییر کرده و دلیل آن باشد.
اصلاح خودکار آسیبپذیری چه تفاوتی با وصلهگذاری دستی دارد؟
وصلهگذاری دستی نیازمند یک مهندس یا توسعهدهنده امنیتی است که یافتهها را بخواند، آسیبپذیری را درک کند، در مورد رفع ایمن آن تحقیق کند، آن را پیادهسازی کند، آزمایش کند و برای بررسی ارسال کند. اصلاح خودکار آسیبپذیری، رفع خودکار را بر اساس نوع آسیبپذیری، زبان، چارچوب و قراردادهای کدنویسی ایجاد میکند و زمان از یافتن تا رفع آن را از روزها یا هفتهها به ساعتها یا دقیقهها کاهش میدهد و به جای یک مشکل در هر زمان، کل صف یافتن را بررسی میکند.
چه ارتباطی بین کاهش نویز و کاهش عقبماندگی امنیتی وجود دارد؟
آنها دو روی یک مشکل هستند. نویز (سیگنال پایین، غیرقابل بهرهبرداری یا یافتههای مثبت کاذب) انبار را با مواردی پر میکند که هرگز نباید به صف توسعهدهنده میرسیدند. کاهش نویز از طریق اولویتبندی هوش مصنوعی، آن موارد را از بالادست حذف میکند، بنابراین انبار فقط شامل خطرات واقعی است. سپس AutoFix آن خطرات واقعی را سریعتر میبندد. این ترکیب، انبار را از هر دو طرف به طور همزمان کاهش میدهد.
