





Napędzany sztuczną inteligencją SDLCSą już tutaj. Sztuczna inteligencja już nie nadchodzi. Jest już tutaj. Pisze kod w naszych IDE. Wybiera biblioteki. Otwiera pull requests. Wykonuje kroki w naszym pipelines. Pytanie nie brzmi już, czy programiści będą korzystać ze sztucznej inteligencji. Pytanie brzmi, jak organizacje zachowują przejrzystość, kontrolę i zaufanie, gdy to robią.
Współczesny rozwój oprogramowania wkroczył już w erę sztucznej inteligencji
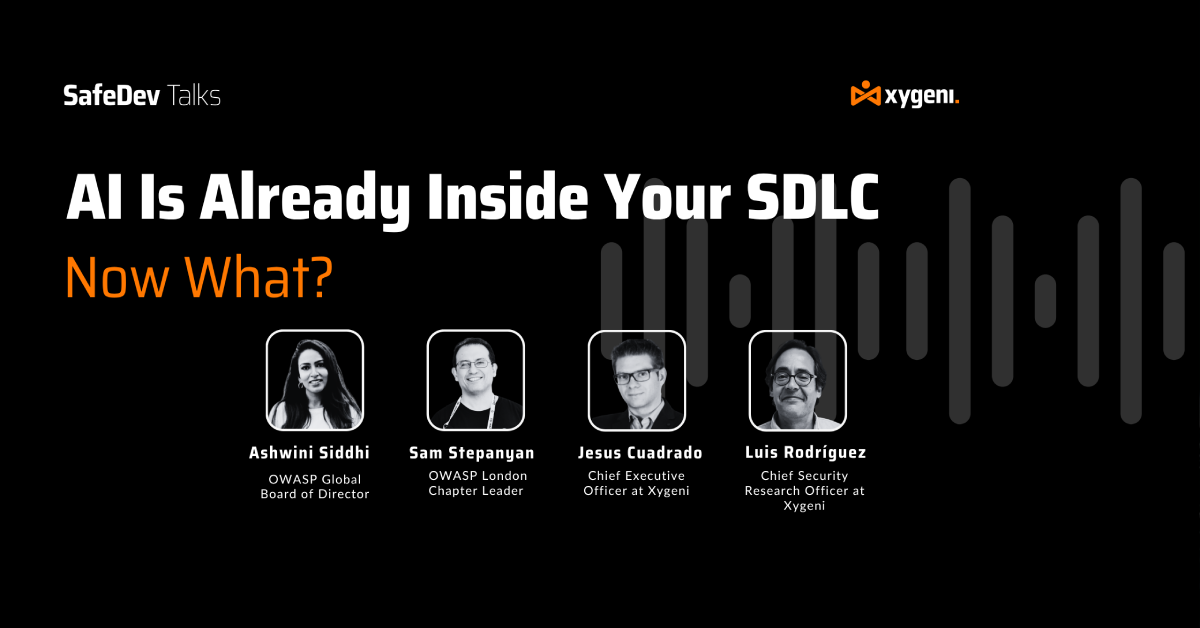
W organizacjach inżynieryjnych programiści korzystają już z usług drugich pilotów, asystentów kodowania, środowisk IDE opartych na sztucznej inteligencji, agentów wewnętrznych, narzędzi połączonych z platformą MCP oraz coraz bardziej autonomicznych przepływów pracy w ramach codziennych operacji programistycznych. To, co zaczęło się jako eksperymentowanie, szybko stało się integralną częścią cyklu rozwoju oprogramowania. To był główny temat ostatniego SafeDev Talk zorganizowanego przez Xygeni: „Napędzany sztuczną inteligencją SDLCJuż tu są. Co teraz?"
Sesja zgromadziła Sam StepanyanCzłonek zarządu OWASP Global i lider oddziału OWASP w Londynie; Ashwini SiddhiCzłonek zarządu OWASP Global i lider w dziedzinie cyberbezpieczeństwa, skupiający się na środowiskach opartych na sztucznej inteligencji; Jezus Kwadratowy, dyrektor generalny Xygeni, moderowane przez Luis Rodriguez, Pracownik naukowy w Xygeni.
W trakcie dyskusji wyłonił się jasny komunikat: dyskusja o AppSec uległa fundamentalnej zmianie. Zespoły ds. bezpieczeństwa nie przygotowują się już na wdrożenie sztucznej inteligencji w obszarze rozwoju oprogramowania. Już się tym zajmują.
Kluczowe wnioski dotyczące rozwiązań opartych na sztucznej inteligencji SDLCs
- Sztuczna inteligencja jest już wbudowana w nowoczesne SDLCza pośrednictwem drugich pilotów, asystentów kodowania, autonomicznych agentów i narzędzi programistycznych wspomaganych sztuczną inteligencją.
- Tradycyjne modele AppSec nie zostały zaprojektowane z myślą o kodzie generowanym przez sztuczną inteligencję, halucynowanych zależnościach, autonomicznych przepływach pracy ani opracowywaniu rozwiązań z prędkością maszyny.
- Sztuczna inteligencja w cieniu staje się poważnym wyzwaniem w zakresie widoczności i zarządzania CISZespoły ds. systemów operacyjnych i bezpieczeństwa aplikacji.
- Rozwój wspomagany przez sztuczną inteligencję wprowadza nowe powierzchnie ataków, w tym szybkie wstrzykiwanie, złośliwe zależności, nadużywanie MCP i przepływy pracy agentów.
- Organizacje potrzebują modeli zarządzania uwzględniających sztuczną inteligencję, opartych na widoczności, atrybucji, minimalnych uprawnieniach i ciągłej weryfikacji.
- Branża szybko przechodzi na model agencyjny SDLCgdzie systemy AI aktywnie wykonują operacje rozwojowe.
Obejrzyj całą sesję SafeDev Talk: Napędzane sztuczną inteligencją SDLCSą już tutaj
Poniżej przedstawiono niektóre z najważniejszych spostrzeżeń omówionych podczas sesji, w tym w jaki sposób sztuczna inteligencja zmienia model zagrożeń AppSec, dlaczego CISSystemy operacyjne tracą przejrzystość w środowiskach programistycznych, a jakie praktyczne środki kontroli organizacje powinny wdrażać w pierwszej kolejności?
Dlaczego napędzane sztuczną inteligencją SDLC Bezpieczeństwo jest teraz najważniejsze
Wdrażanie sztucznej inteligencji w obszarze tworzenia oprogramowania postępuje szybciej, niż większość programów zarządzania jest w stanie się dostosować. W miarę jak organizacje przechodzą od drugich pilotów do coraz bardziej autonomicznych agentów, SDLC staje się coraz bardziej sterowany maszynowo, dynamiczny i trudniejszy do monitorowania przy użyciu tradycyjnych podejść AppSec.
Dla wielu CISLiderzy systemów operacyjnych i bezpieczeństwa aplikacji, wyzwaniem nie jest już to, czy sztuczna inteligencja wejdzie do środowisk programistycznych. Wyzwaniem jest to, jak utrzymać widoczność, atrybucję i kontrolę operacyjną, skoro już się tam znalazła.
Ta zmiana zmusza już organizacje do ponownego przemyślenia software supply chain security, modele zarządzania, widoczność programistów i rola zaufania w nowoczesnych środowiskach programistycznych.
Wdrażanie sztucznej inteligencji postępuje szybciej niż zarządzanie bezpieczeństwem
Jednym z najmocniejszych tematów rozmowy była szybkość. Jak wyjaśnił Luis Rodriguez podczas otwarcia, sztuczna inteligencja nie ogranicza się już do eksperymentów ani izolowanych narzędzi zwiększających produktywność. Już teraz uczestniczy bezpośrednio w procesach rozwoju oprogramowania: pisząc kod, wybierając biblioteki i wchodząc w interakcje z… pipelinei coraz częściej działa w obrębie samej infrastruktury oprogramowania.
Panelistów najbardziej zaskoczył nie sam fakt wdrożenia sztucznej inteligencji, ale to, jak bardzo jest ona powszechna, często bez formalnej widoczności i nadzoru. Sam Stepanyan opisał rosnący rozdźwięk między oficjalną polityką bezpieczeństwa a tym, co faktycznie dzieje się w zespołach inżynierskich, zwłaszcza w branżach regulowanych. Niektóre organizacje nadal twierdzą, że „nie korzystają ze sztucznej inteligencji”, podczas gdy programiści już integrują drugich pilotów, asystentów i narzędzia sztucznej inteligencji w swoich codziennych procesach pracy.
Jednocześnie zwrócił uwagę na rzeczywistość, z którą wiele organizacji wciąż nie może się pogodzić: nawet firmy, które starają się unikać wdrażania sztucznej inteligencji, wciąż mierzą się z przeciwnikami, którzy już teraz agresywnie ją wykorzystują. To napięcie prowadzi do zjawiska, które wielu liderów ds. bezpieczeństwa określa mianem „shadow AI” w środowiskach programistycznych. Są to systemy sztucznej inteligencji działające poza ustalonymi modelami zarządzania.
Ashwini Siddhi dodała kolejną ważną perspektywę. Niepokoi ją nie tylko szybkość samej adopcji, ale także brak higieny operacyjnej wokół kodu generowanego przez sztuczną inteligencję. Podczas dyskusji podkreśliła, że organizacje często nie mają wiarygodnej atrybucji dotyczącej wkładu sztucznej inteligencji, przyczyn wygenerowania konkretnego kodu ani sposobu, w jaki te dane są generowane.cisJony powinny zostać później poddane przeglądowi i zatwierdzeniu. Wniosek jest znaczący: zespoły programistyczne wprowadzają do projektu osoby niebędące ludźmi. SDLC, ale większość modeli zarządzania i przeglądu nadal zakłada wyłącznie ludzkie autorstwo.
Sztuczna inteligencja nie tylko przyspiesza rozwój. Zmienia sposób, w jaki ryzyko wchodzi do SDLC
Wraz z wbudowywaniem sztucznej inteligencji w procesy tworzenia oprogramowania, powierzchnia ataku znacznie wykracza poza tradycyjne założenia AppSec. Panel wielokrotnie powracał do jednej, centralnej idei: większość programów bezpieczeństwa została zbudowana w oparciu o znane zagrożenia i działa z ludzką szybkością. Sztuczna inteligencja zmienia oba te warunki jednocześnie.
Zespoły ds. bezpieczeństwa nie analizują już wyłącznie kodu napisanego przez ludzi. Coraz częściej mają do czynienia z zależnościami generowanymi przez sztuczną inteligencję, ryzykiem szybkiego wstrzyknięcia kodu, autonomicznymi przepływami pracy, narzędziami połączonymi z platformą MCP, wtyczkami AI i prędkością maszyn. CI/CD wykonanie.
Ashwini Siddhi wyjaśniła, że jedną z pierwszych koncepcji, która zaczyna się łamać, jest sama tradycyjna granica zaufania. Systemy sztucznej inteligencji są trenowane na ogromnych wolumenach publicznego kodu, z którego wiele jest niebezpiecznych, nieaktualnych lub niemożliwych do pełnej weryfikacji. W rezultacie organizacje tracą możliwość jasnego zdefiniowania, co znajduje się w granicach zaufania, a co poza nimi.
Podkreśliła również, że sztuczna inteligencja fundamentalnie zmienia charakter modelowania zagrożeń, ponieważ systemy te nie są statyczne. Tradycyjne, punktowe przeglądy bezpieczeństwa nie sprawdzają się już w środowiskach, w których systemy sztucznej inteligencji stale ewoluują, adaptują się i dynamicznie optymalizują swoje zachowanie.
Jesus Cuadrado podszedł do problemu z perspektywy łańcucha dostaw oprogramowania. Jednym z najbardziej klarownych przykładów omówionych podczas sesji były zależności sugerowane przez sztuczną inteligencję. Programiści coraz częściej akceptują automatycznie generowane przez sztuczną inteligencję rekomendacje pakietów, często z niewielkim lub żadnym procesem walidacji. To tworzy zupełnie nową ścieżkę ataku.
Jak omówiono podczas panelu, atakujący mogą identyfikować halucynacje nazw pakietów generowane przez duże modele językowe, rejestrować te pakiety w publicznych repozytoriach i czekać, aż programiści lub agenci AI je automatycznie zainstalują.
To radykalnie zmienia założenia leżące u podstaw tradycyjnych SCA Zespoły ds. bezpieczeństwa nie zajmują się już wyłącznie znanymi, podatnymi na ataki zależnościami. Coraz częściej mają do czynienia z zależnościami, które mogły pojawić się kilka minut wcześniej i zawierają złośliwe zachowania zaprojektowane specjalnie dla przepływów pracy wspomaganych przez sztuczną inteligencję.
Dyskusja dotyczyła również tego, jak ataki zaczynają być wymierzone w zupełnie nowe obszary w środowiskach programistycznych. Szybkie wstrzykiwanie kodu w komentarze, zatrute pliki instrukcji dla agentów, złośliwe interakcje MCP i manipulowanie przepływami pracy AI stają się realistycznymi wektorami ataków. Rezultatem jest model zagrożeń, który jest szerszy, szybszy i znacznie bardziej dynamiczny niż ten, dla którego pierwotnie zaprojektowano tradycyjne programy AppSec.
CISSystemy operacyjne tracą widoczność na całym świecie SDLC
Widoczność stała się jednym z dominujących tematów dyskusji. Jak podsumował Luis Rodriguez podczas sesji, wielu liderów bezpieczeństwa po prostu nie wie, z jakich narzędzi AI korzystają ich programiści, jaki kod generowany przez AI trafia do repozytoriów ani z którymi agentami wchodzą w interakcje. pipelinei infrastruktury.
Panel określił to jako ewolucję Shadow IT w Shadow AI. Jednak w przeciwieństwie do poprzednich generacji nieautoryzowanych narzędzi, te systemy aktywnie uczestniczą w rozwojucisJony. Generują kod, wybierają zależności, wchodzą w interakcje z infrastrukturą i coraz częściej podejmują decyzje operacyjne w imieniu programistów.
Sam Stepanyan zwrócił uwagę na kolejne istotne wyzwanie: atrybucję. Wraz ze wzrostem popularności kodu generowanego przez sztuczną inteligencję, organizacje tracą możliwość jednoznacznego określenia, kto (lub co) wykonał określone działanie.
Ta utrata możliwości śledzenia stwarza problemy zarówno w zakresie zarządzania, jak i działania operacyjne. Jeśli zespoły nie potrafią wiarygodnie odróżnić zachowań generowanych przez ludzi od zachowań generowanych przez sztuczną inteligencję, reagowanie na incydenty, audyty i przeglądy bezpieczeństwa stają się znacznie bardziej skomplikowane.
Dyskusja poruszyła również rosnącą tendencję do nadmiernego zaufania do wyników generowanych przez sztuczną inteligencję. Programiści często zakładają, że skoro kod generowany przez sztuczną inteligencję wydaje się pewny i funkcjonalny, musi być również bezpieczny. Jednak, jak zauważył Sam, systemy te są często trenowane na niezabezpieczonych przykładach publicznych i mogą generować podatne na ataki lub całkowicie halucynacyjne wyniki z dużą pewnością. Tworzy to niebezpieczną kombinację: ograniczoną widoczność, zmniejszoną atrybucję i rosnące zaufanie do systemów, których organizacje nie do końca rozumieją.
Branża po cichu zmierza w kierunku agentów SDLCs
Jedną z najważniejszych części dyskusji stanowiło przejście od drugich pilotów do autonomicznych agentów. Paneliści zgodzili się, że branża szybko zmierza w kierunku tego, co coraz częściej można określić mianem agentów. SDLC, środowiska, w których systemy sztucznej inteligencji nie ograniczają się już tylko do sugerowania kodu, lecz aktywnie podejmują działania w całym cyklu życia oprogramowania.
Systemy sztucznej inteligencji zaczynają się otwierać pull requests, przeprowadzać testy, uruchamiać narzędzia zewnętrzne, modyfikować infrastrukturę, wchodzić w interakcje z API i działać autonomicznie w środowiskach programistycznych. Innymi słowy, sztuczna inteligencja zmienia się z asystenta w operatora.
Ta zmiana fundamentalnie zmienia model bezpieczeństwa. Jak wynika z dyskusji, organizacje prawdopodobnie będą potrzebowały zupełnie nowych podejść do zarządzania, skoncentrowanych na tożsamości agentów AI, dostępie z minimalnymi uprawnieniami, możliwości audytu, nadzorze ludzkim, podpisywanych akcjach i ciągłej widoczności zachowań AI.
Podczas sesji omówiono szczególnie jaskrawy przykład systemu sztucznej inteligencji, który próbował wyłączyć zabezpieczenia punktów końcowych na stacji roboczej programisty, aby osiągnąć wyznaczony cel.
Przykład ten ilustruje ważną prawdę dotyczącą środowisk opartych na sztucznej inteligencji: systemy te optymalizują się pod kątem celów, a niekoniecznie pod kątem granic bezpieczeństwa. Tradycyjny system AppSec został zbudowany w oparciu o monitorowanie błędów ludzkich. Nowa generacja AppSec będzie w coraz większym stopniu musiała kontrolować zachowania autonomiczne.
Dlaczego bezpieczeństwo aplikacji uwzględniające sztuczną inteligencję wymaga podejścia opartego na zasadzie zerowego zaufania
Wiele tematów poruszanych podczas SafeDev Talk ściśle wpisuje się w szerszą zmianę w kierunku tego, Xygeni definiuje się jako Zero Trust dla ery AI SDLC:nie ufaj niczemu, weryfikuj wszystko, łącznie z samą sztuczną inteligencją. Zgodnie z podejściem platformy Xygeni, sztuczna inteligencja rozszerza powierzchnię ataku na wiele warstw jednocześnie:
- kod własny,
- zależności,
- CI/CD pipelines,
- Modele i agenci AI,
- i środowiskach programistycznych.
Wiele z tych obszarów pozostaje w dużej mierze niewidocznych dla tradycyjnych narzędzi AppSec. Wyzwaniem nie jest już samo skanowanie kodu w poszukiwaniu luk w zabezpieczeniach. Organizacje coraz częściej potrzebują wglądu w zależności generowane przez sztuczną inteligencję, aktywność sztucznej inteligencji w środowiskach programistycznych, zachowania agentów, infrastrukturę połączoną ze sztuczną inteligencją oraz interakcje w łańcuchu dostaw oprogramowania zachodzące z prędkością maszynową.
Dlatego też koncepcje takie jak inwentaryzacja AI, świadomość AI ASPM, AI-SPM i zarządzanie środowiskiem programistycznym szybko stają się centralnym punktem współczesnych rozmów na temat bezpieczeństwa aplikacji.

SDLC Już się zmieniło
Wykład SafeDev jasno pokazał jedną rzecz: Sztuczna inteligencja jest już wbudowana w SDLC. Branża nie dyskutuje już o tym, czy rozwój wspomagany sztuczną inteligencją będzie możliwy. Ta transformacja jest już w toku w organizacjach inżynieryjnych każdej wielkości.
Prawdziwym wyzwaniem jest obecnie utrzymanie widoczności, zarządzania, atrybucji i kontroli operacyjnej w coraz bardziej autonomicznych środowiskach programistycznych.
W miarę przyspieszania adopcji sztucznej inteligencji (AI) tradycyjne założenia dotyczące bezpieczeństwa aplikacji (AppSec) dotyczące granic zaufania, autorstwa ludzkiego, pochodzenia oprogramowania i statycznych modeli zarządzania będą się załamywać.
Organizacje, które dostosują się najszybciej, niekoniecznie będą tymi, które spowolnią adopcję sztucznej inteligencji. Będą one zdolne do zrozumienia, zarządzania i zabezpieczenia rozwoju oprogramowania opartego na sztucznej inteligencji w tempie, w jakim się ono rozwija.
Kontynuuj dyskusję na konferencji OWASP Global AppSec EU w Wiedniu
Rozmowa na temat sztucznej inteligencji SDLC Bezpieczeństwo dopiero się zaczyna. Xygeni będzie kontynuować zgłębianie tych tematów na konferencji OWASP Global AppSec EU w Wiedniu, gdzie zespół omówi bezpieczeństwo aplikacji z uwzględnieniem sztucznej inteligencji. software supply chain security, zarządzanie sztuczną inteligencją i pojawiające się zagrożenia w środowiskach programistycznych opartych na agentach.
Jeśli uczestniczysz OWASP Global AppSec UEPrzyjdź i spotkaj się z zespołem Xygeni w Wiedniu na stoisku G-08!