






To czwarty odcinek z serii seria postów o złośliwych komponentach, gdzie przedstawiamy Xygeni podejście do radzenia sobie z tym zagrożeniem w ramach naszego zasięgu Open Source Security.
Zaobserwowaliśmy, że nadmierne zaufanie do komponentów open source o niepewnym źródle jest wykorzystywane przez wszelkiego rodzaju przestępców do wywoływania nieoczekiwanych zachowań, które mogą być uruchamiane na maszynach programistów, CI/CD systemy lub osadzone w oprogramowaniu organizacji ofiary, dzięki czemu jest ono przekazywane klientom organizacji. Dokonaliśmy analizy odcinek nr 2 ataki wykorzystujące rejestry publiczne do dostarczania złośliwego oprogramowania i czego dowiedzieliśmy się po obserwowaniu sposobu działania złoczyńców, a także w poprzednich odcinek nr 3 Przeanalizowano skuteczne (i nieskuteczne) środki kontroli w obliczu tego zagrożenia.
Czas przyjrzeć się naszemu podejściu do problemu. W tym odcinku przedstawiamy strategię, którą stosujemy w Xygeni w odniesieniu do naszych Wczesne ostrzeganie przed złośliwym oprogramowaniem System (MEW). Jak ten wieloetapowy system działa w czasie rzeczywistym po wydaniu nowej wersji pakietu, jak gromadzone są dowody z różnych źródeł, jak przeprowadzana jest selekcja, jakich kryteriów klasyfikacji przestrzegamy i dlaczego konieczna jest ręczna analiza, aby potwierdzić naturę kandydata na złośliwy pakiet. Wyjaśnimy również, jak pomagamy NPM, GitHub, PyPI i innym kluczowym infrastrukturom w ekosystemach open source w skracaniu czasu pozostawania złośliwego oprogramowania w systemie.
pipeline
Wczesne ostrzeganie przed złośliwym oprogramowaniem Xygeni (MEW) to stale przetwarzający komponent, albo pakiety tarball dla bibliotek i struktur dla obsługiwanych ekosystemów programistycznych, takich jak JavaScript/Node lub Python, obrazy kontenerów Docker/OCI, albo rozszerzenia i wtyczki dla narzędzi, takich jak środowiska IDE lub CI/CD Systemy. Takie komponenty są publikowane w rejestrach publicznych o różnym poziomie weryfikacji użytkowników.
Poniżej przedstawiono schemat działania systemu:
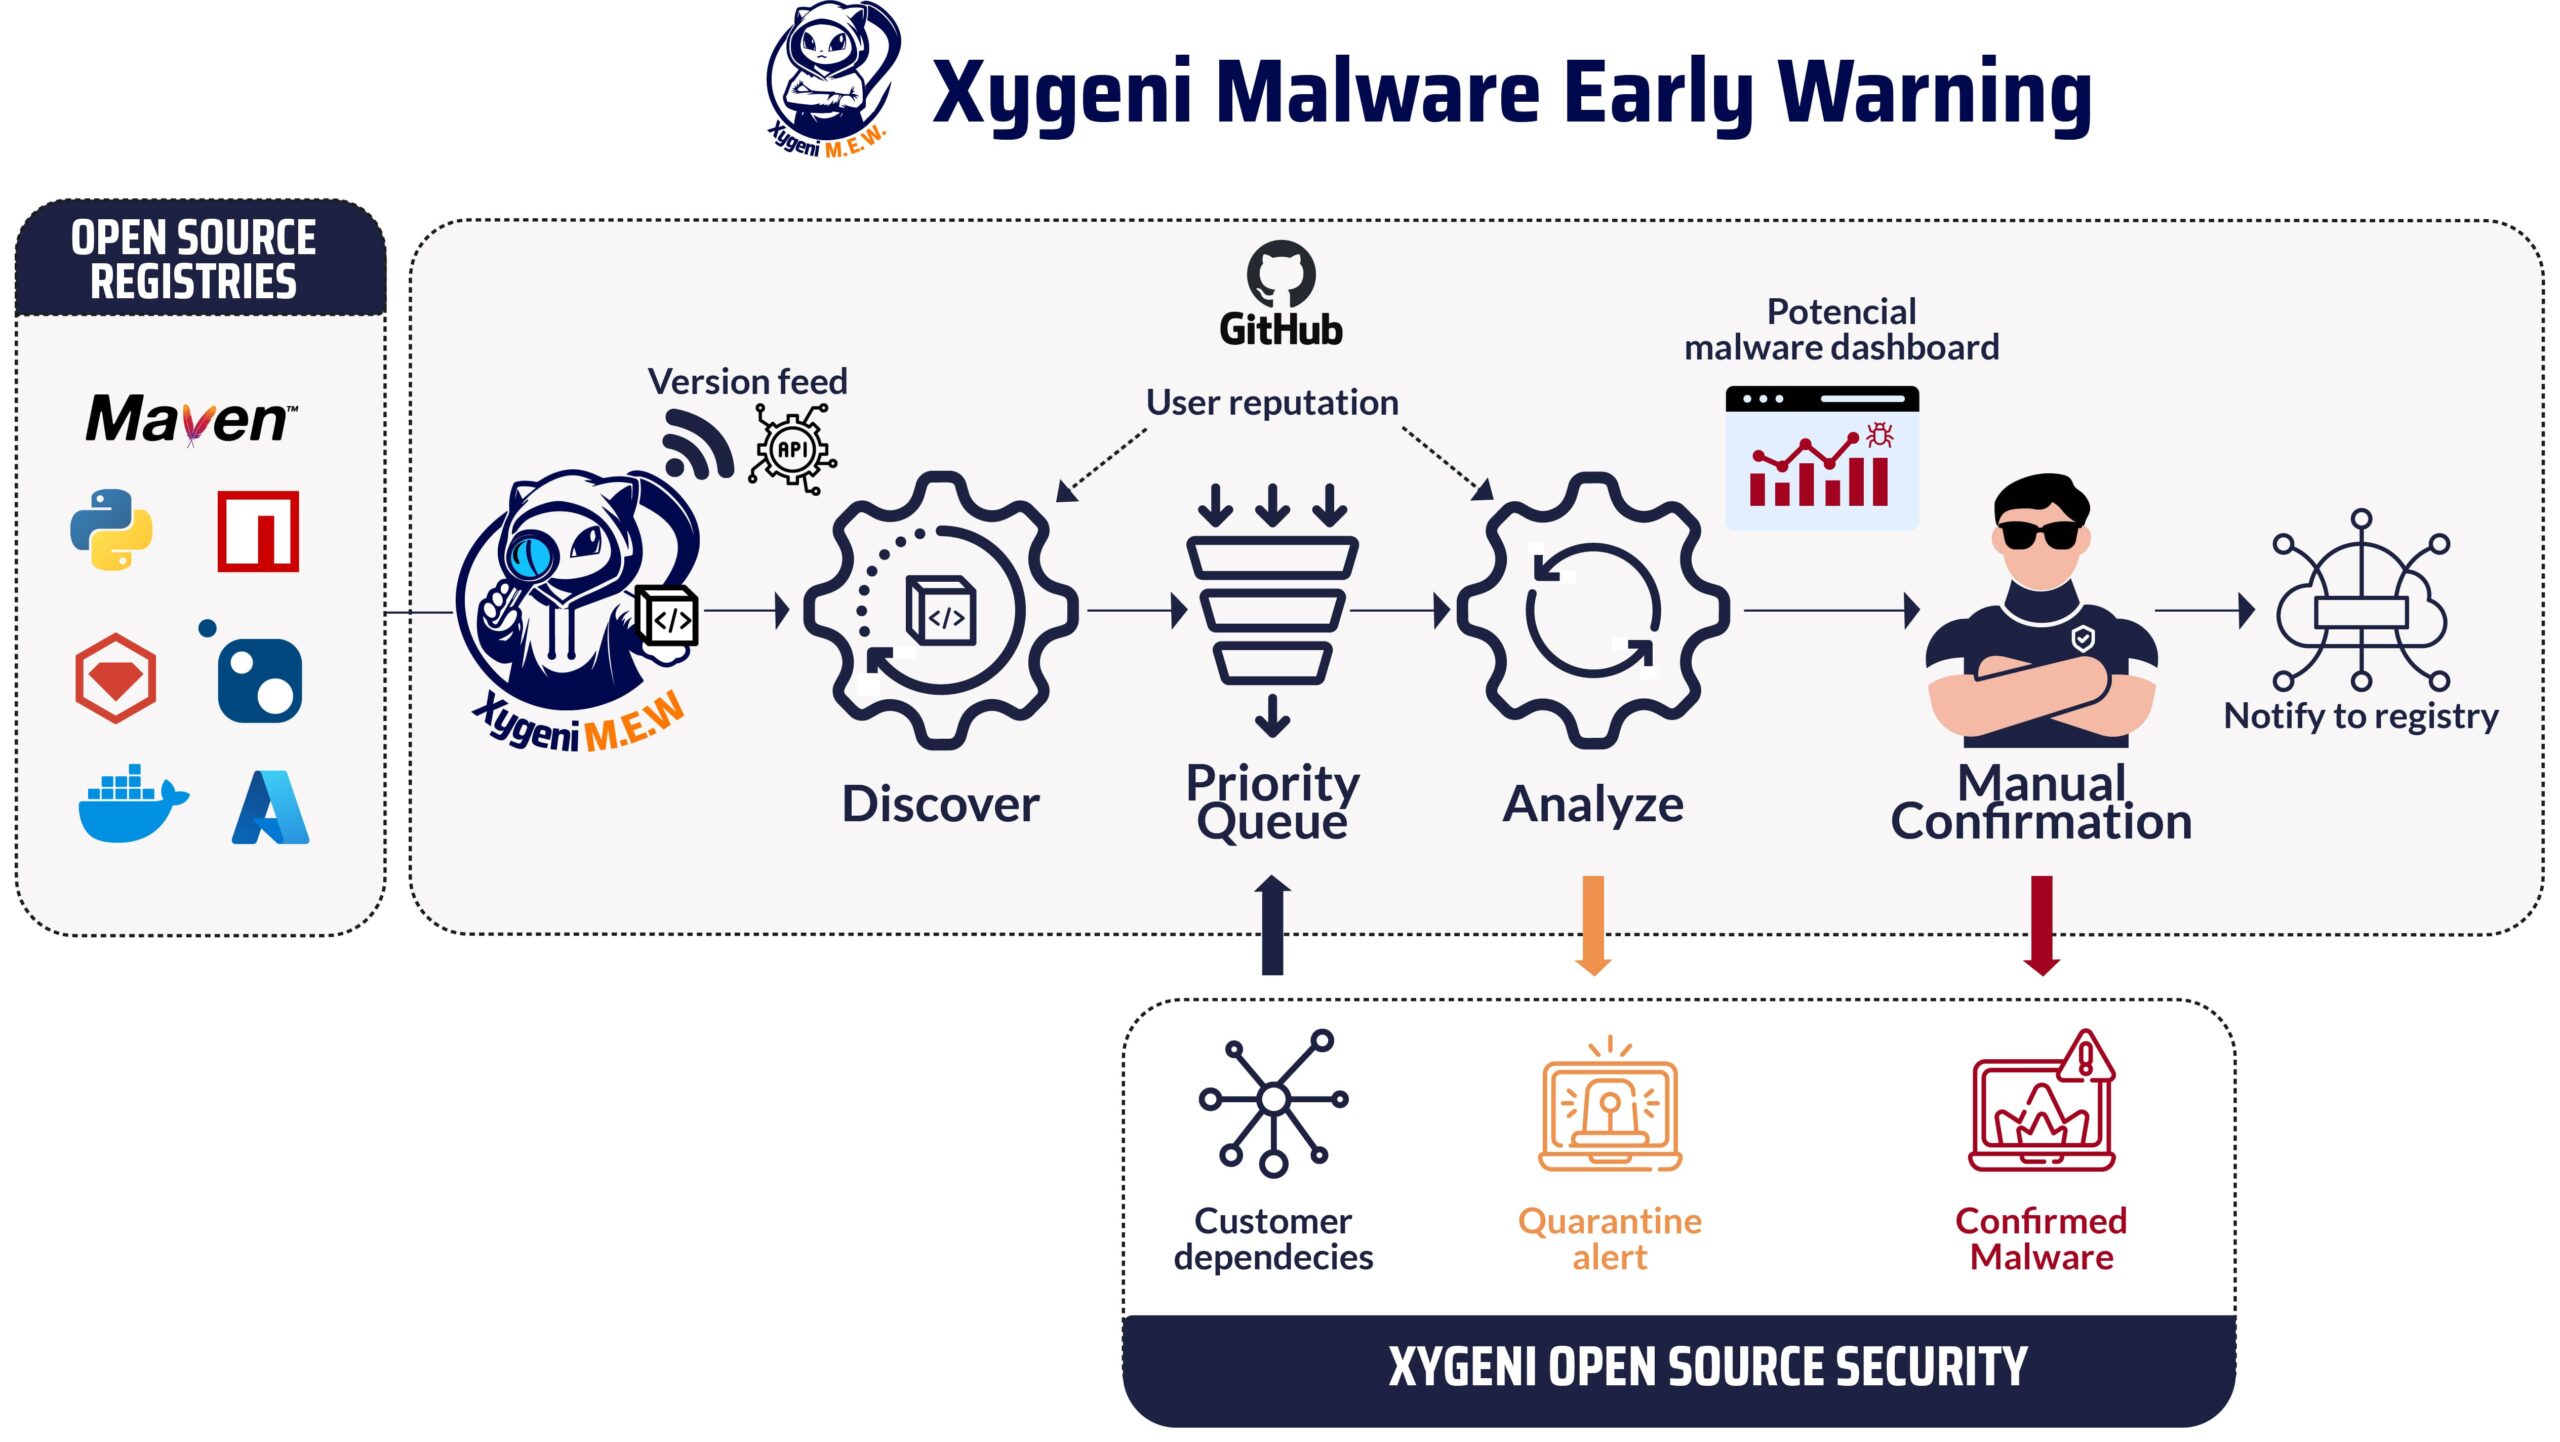
odkrywca Proces pobiera informacje o zdarzeniach publikacyjnych. Zdarzenie publikacyjne to utworzenie nowej wersji nowego lub istniejącego komponentu. Ponieważ popularne rejestry nie oferują mechanizmu publikacji i subskrypcji dla zainteresowanych użytkowników, często odbywa się to poprzez odpytywanie rejestru o ostatnie zdarzenia. Doskonały projekt OSSF, pakiety-kanały, wsparcie popularne rejestry, takie jak PyPI czy Maven Central, i zapewniają ujednolicony interfejs oparty na kanałach. W MEW dodaliśmy kilka konkretnych implementacji, które skracają czas oczekiwania, na przykład replikę bazy danych CouchDB używanej przez NPM, która jest zsynchronizowana z publiczną bazą danych rejestru.
W Xygeni mamy inwentarz[1] wszystkich komponentów (bezpośrednio lub pośrednio) używanych przez oprogramowanie naszych klientów. Współrzędne komponentów klientów są regularnie przesyłane do MEW w celu ustalenia priorytetów analiz: komponenty używane przez naszych klientów są przetwarzane wcześniej. Priorytet zależy również od reputacji wydawcy i krytyczności komponentu, dlatego komponenty pochodzące od wydawców o niskiej reputacji również są traktowane priorytetowo.
analizatory Następnie pobiera oczekujące komponenty z kolejki priorytetowej. Po wybraniu wersji komponentu do analizy, jej archiwum tarball jest pobierane z rejestru. Należy pamiętać, że analizowany jest spakowany, binarny komponent: większość komponentów open source zazwyczaj pochodzi z repozytorium open source, często na github.com, które służy wyłącznie do celów kontekstowych, a złośliwe oprogramowanie jest zawsze wyszukiwane w archiwum tarball, ponieważ atakujący systematycznie kłamią na temat źródeł, z których rzekomo korzystali, budując udostępniane archiwum tarball.
Z perspektywy użytkownika
Słyszę, jak myślisz: Jak mogę skorzystać z wcześniejszej wiedzy o złośliwej wersji pakietu? W odcinku „Anatomia złośliwych pakietów: jakie są trendy?” Zaobserwowaliśmy, że całkowity czas oczekiwania mieści się w przedziale dni, podczas gdy pierwsze powiadomienie od MEW do klientów korzystających z uszkodzonego komponentu mieści się w przedziale minut. Z prostą barierą ochronną[2] Możesz zablokować kompilację (istnieją dwa poziomy alertów: jeden w pełni automatyczny, gdy silnik wykryje potencjalne złośliwe oprogramowanie, oraz późniejsze powiadomienie, gdy nasz zespół ds. bezpieczeństwa potwierdzi obecność złośliwego oprogramowania poprzez ręczną inspekcję). Czekanie, aż rejestr potwierdzi obecność złośliwego oprogramowania i usunie je z rejestru, jest zazwyczaj zbyt późne ze względu na długi czas reakcji.
Organizacja może wykorzystać mechanizm sprawdzający, czy istnieje komponent potencjalnie zawierający złośliwe oprogramowanie (na dowolnym z dwóch poziomów zagrożenia) lub za pośrednictwem interfejsu API szybko dowiedzieć się, czy któraś z bezpośrednich lub pośrednich zależności w projekcie oprogramowania wykorzystuje złośliwy komponent.
Jak działa MEW: szczegóły wewnętrzne
Rdzeń: Silnik wykrywania złośliwego oprogramowania
Analizator wykorzystuje różne detektory do gromadzenia dowodów nadużyć. Detektory łączą analizę statyczną, analizę możliwości i analizę kontekstu.[3], jak opisano w poprzednim poście z tej serii.
W Xygeni mamy zespół inżynierów z wieloletnim doświadczeniem w analizie statycznej, co stanowi główną różnicę w porównaniu z innymi rozwiązaniami antywirusowymi. Należy pamiętać, że w przypadku niektórych ekosystemów spakowany plik tarball zawiera albo kod źródłowy (np. kod JavaScript lub TypeScript dla pakietów NPM, kod źródłowy Pythona dla pakietów PyPI), albo skompilowany kod wystarczająco zbliżony do kodu źródłowego, aby umożliwić analizę statyczną (np. kod bajtowy w plikach JAR dla Mavena). W przypadku innych, takich jak obrazy kontenerów, powszechne są binarne pliki wykonywalne, dlatego stosowana jest technika wnioskowania o możliwościach, wraz z konwencjonalnym wykrywaniem złośliwego oprogramowania opartym na regułach YARA i sygnaturach.
Należy pamiętać, że proste technologie, takie jak wyrażenia regularne czy podpisy, nie nadają się do wykrywania złośliwego zachowania. Wyobraź sobie wykrycie droppera lub downloadera: Jakiś kod lub plik binarny znajduje się w pakiecie lub jest pobierany z domeny zewnętrznej, niezwiązany z komponentem (może to być kod z domeny zewnętrznej). długa lista domen zakupionych przez osobę stwarzającą zagrożenie[4], Lub legalna domena, aby uniknąć wykrycia). Kod ten jest następnie wykonywany za pomocą jednej z funkcji. Kod można przekształcić, aby ukryć adres URL pobierania lub funkcję używaną do uruchomienia pobranego kodu. Do wykrycia tego potrzebna jest pełna analiza przepływu danych, z wykorzystaniem pełnego mechanizmu analizy statycznej, lub wykonanie w trybie sandbox (jeśli warunki uruchomienia złośliwego zachowania są rzeczywiście spełnione), co w ogólnym przypadku mogłoby to wykryć.
Aktorzy zagrożeń stosują te same techniki, a detektory zostały zaprojektowane i wdrożone. Istnieją również pewne kroki wstępnego przetwarzania, na przykład w celu usunięcia zaciemnienia, często niezbędne do wykrycia ukrytego zachowania.
Dodawanie kontekstu
Niektóre detektory wykorzystują informacje kontekstowe. Na przykład niezgodność między wersją w rejestrze komponentu a tagiem/wydaniem w powiązanym repozytorium GitHub stanowi silny dowód na to, że atakujący mógł uzyskać uprawnienia do publikacji w rejestrze, ale nie w repozytorium GitHub. Ataki takie jak ten, który dotknął dostawcę portfela kryptowalut, Księga główna można łatwo wykryć na podstawie tej niezgodności.
A wynik złośliwości (MS) jest obliczany na podstawie wyników uzyskanych z uruchomionych detektorów, w oparciu o siłę zebranych dowodów. Nie wszystkie wyniki są takie same, a kolejność wykonywania jest istotna.
Reputacja użytkowników i komponentów
Nie wszyscy twórcy oprogramowania open-source są sobie równi!
Renomowany deweloper może paść ofiarą przejęcia konta NPM (zdarza się to nawet osobom dbającym o bezpieczeństwo) i opublikowania złośliwego oprogramowania za jego pośrednictwem. Oczywiście reputacja powinna gwałtownie spaść i odzyskać dawną świetność dopiero po odzyskaniu przejętego konta i naprawieniu przez dewelopera warunków, które doprowadziły do przejęcia konta. Reputację trudno zdobyć, ale można ją stracić w mgnieniu oka.
W MEW wdrożyliśmy kompleksowy system zarządzania reputacją, aby nagradzać pozytywne zachowania i karać za podejrzane działania. System rozpoczyna się od neutralnej postawy nowych użytkowników i dostosowuje ich reputację na podstawie ich bieżących działań.
Reputacja użytkownika poprawia się dzięki pozytywnym działaniom, takim jak utrzymywanie aktywnych kont w mediach społecznościowych, włączanie uwierzytelniania wieloskładnikowego, regularne uczestnictwo w projektach i podpisywanie commitz weryfikowalnymi kluczami. Z drugiej strony, reputacja pogarsza się z powodu wrogich działań, takich jak publikowanie złośliwego oprogramowania, używanie jednorazowych adresów e-mail, brak podpisywania commitlub wykazujące nietypowe wzorce w swoich składkach.
Głównym celem naszego systemu jest zapewnienie bezpiecznego i godnego zaufania środowiska. Osiągamy to poprzez dynamiczne dostosowywanie reputacji użytkowników na podstawie różnych czynników, przy jednoczesnym poszanowaniu kwestii prywatności i ograniczeń różnych rejestrów.
Dla użytkownika obliczany jest wewnętrzny wynik reputacji (po dołączeniu do rejestru i konta GitHub, jeśli to możliwe), a także wynik złośliwości używany podczas klasyfikowania analizowanego komponentu oraz w celu lepszego określenia, kto podlega publikacji danego komponentu.
Znaleziono dowody na złośliwe zachowanie. I co z tego? Ręczny proces weryfikacji
Obecny klasyfikator przypisuje analizowaną wersję komponentu do jednej z kategorii: „potwierdzona złośliwość”, „prawdopodobnie złośliwość”, „wysokie ryzyko”, „niskie ryzyko” lub „niezłośliwość” na podstawie progów punktacji podsumowującej wyniki oraz reputacji użytkownika/komponentu. Klasyfikacja do kategorii „wysokie ryzyko” lub „prawdopodobnie złośliwość” uruchamia ręczny przegląd i pierwsze powiadomienie. Kategoria „potwierdzona złośliwość” jest ustawiana po ręcznym przeglądzie lub gdy dowody pokrywają się z tymi samymi dowodami dla poprzedniej wersji, która została potwierdzona jako złośliwa.
Gdy istnieje wystarczająca ilość dowodów na potencjalne szkodliwe zachowanie, do organizacji, których to dotyczy, wysyłany jest pierwszy alert (alert kwarantanny). Jak wspomniano wcześniej, może to zablokować instalację lub kompilację oprogramowania zależnego od komponentu poddanego kwarantannie.
To stwarza problem w wewnętrznym systemie MEW dashboard Analitycy bezpieczeństwa mogą więc rozpocząć ręczny proces przeglądu komponentu. Zespół dysponuje specjalistycznymi narzędziami (piaskownica, deobfuskatory, dystrybucja do badań nad złośliwym oprogramowaniem, narzędzia do raportowania złośliwego oprogramowania) umożliwiającymi szybką ocenę charakteru badanej wersji komponentu. Większość złośliwego oprogramowania („sardele” lub nieskomplikowane złośliwe komponenty) jest poddawana przeglądowi.
Wynik przeglądu kończy się albo "bezpiecznym"więc automatyczny moduł analizy wykrył fałszywie pozytywny wynik, który jest wykorzystywany jako informacja zwrotna dla klasyfikatora uczenia maszynowego w celu poznania wzorca; lub potwierdzono złośliwość, więc komponent jest odpowiedzialnie ujawniany jako złośliwy w rejestrze publicznym, po zakończeniu procesu raportowania. Drugie powiadomienie jest wysyłane do organizacji, których dotyczy problem, co z kolei może usuń komponent z kwarantanny lub definitywnie zablokuj go w procesie aktualizacji wersji lub zaporze komponentu używanej w wewnętrznym rejestrze.
To ustawienie pozwala nam analizować dziesiątki tysięcy nowych wersji dziennie i identyfikować dziesiątki prawdopodobnie złośliwych, które następnie ręcznie sprawdzamy. Pamiętajcie z poprzedniego odcinka, że jeden na dziesięć tysięcy to częstotliwość występowania złośliwych komponentów w środowisku naturalnym.
Zgłoszenie do Rejestru
Stwierdziliśmy, że większość rejestrów publicznych, stanowiących jeden z filarów infrastruktury open source, oferuje dość ograniczone mechanizmy zgłaszania problemów z bezpieczeństwem, a w szczególności złośliwych komponentów. Dokładamy wszelkich starań, aby ulepszyć podstawową organizację procesu zgłaszania. Zazwyczaj otrzymujemy co najwyżej e-mail z informacją zwrotną od zespołu ds. bezpieczeństwa w rejestrze, potwierdzający usunięcie komponentu z rejestru.
Czasami rejestr jest nadużywany, co narusza jego warunki użytkowania, ale nie powoduje szkodliwego działania w dostarczonym oprogramowaniu. Takie przypadki są również zgłaszane do rejestru, ale nie są one przekazywane organizacjom w celu ograniczenia zakłóceń.
Przyszła praca
Wiele usprawnień jest obecnie w planach. Przede wszystkim publiczny portal dotyczący stanu składników systemu operacyjnego, szczególnie w odniesieniu do dowodów potencjalnej złośliwości, jest obecnie w fazie rozwoju. Ma to być skromny wkład w społeczność open-source. Bądźcie czujni.
Kolejnym trwającym rozwojem jest ulepszona klasyfikator uczenia maszynowego. MEW będzie uczyć się na podstawie wcześniejszych klasyfikacji. Wektor wyników z detektorów silnika, a także uzyskany wynik złośliwości i wynik reputacji zarówno dla komponentu, jak i wydawcy („znalezione dowody”) są wykorzystywane jako dane wejściowe dla systemu uczenia maszynowego, który aktualizuje model klasyfikatora. Zmienną wyjściową jest po prostu to, czy rejestr potwierdził złośliwość komponentu. Ma to nazwę kodową „Oracle” i pomoże w bardziej wstępnymciskwalifikator e, zaprojektowany tak, aby był solidny (wysoki poziom odtworzenia, tzn. nie pomijał złośliwych komponentów), ale dawał mniej fałszywych wyników (nie zgłaszał bezpiecznych komponentów jako złośliwych).
A wynik krytyczności Oprócz przynależności do zestawu zależności klientów i niskiej reputacji wydawcy, zostaną dodane kryteria priorytetyzacji. Oczywiste jest, że projekty o większym wpływie i znaczeniu powinny być wcześniej brane pod uwagę w analizie. Nie będziemy tu wyważać otwartych drzwi i będziemy postępować zgodnie z… Wynik krytyczności projektu Open Source.
Trwają prace nad wsparciem dla kolejnych ekosystemów. W planach są również szeroko rozpowszechnione technologie i narzędzia, takie jak PHP czy wtyczki Jenkins.
Sprawdzamy również, czy proces ręcznego przeglądu można by usprawnić za pomocą sztucznej inteligencji, aby usprawnić analizę kilku bardziej zaawansowanych złośliwych komponentów.
W kolejnej i ostatniej części tej serii „Wykorzystywanie oprogramowania typu open source: czego oczekiwać od złych ludziSkupimy się na najnowszych sposobach, jakie przeciwnicy stosują, aby ataki były bardziej ukryte, trudniejsze do wykrycia, bardziej ukierunkowane na konkretne branże i bardziej dochodowe. Czy ataki ransomware będą przeprowadzane za pomocą tego narzędzia? W jaki sposób cyberprzestępcy wykorzystują narzędzia sztucznej inteligencji do dostarczania bardziej zaawansowanego złośliwego oprogramowania? Czy zagrożone są najpopularniejsze projekty? Celem tego artykułu jest przybliżenie czytelnikom przebiegu tego wyścigu zbrojeń oraz tego, czego można się spodziewać w perspektywie krótkoterminowej (druga połowa 2024 r.) i średnioterminowej (2025 r.).
Na koniec przedstawimy kilka refleksji na temat drobnych kroków, jakie społeczność mogłaby podjąć, nie zmieniając zbytnio otwartości świata open source. Na przykład, bardziej efektywny mechanizm zgłaszania złośliwego oprogramowania do rejestrów publicznych i udostępniania rejestrom i społeczności dowodów na obecność potencjalnie szkodliwych komponentów byłby małym krokiem w dobrym kierunku, jakim jest zamknięcie drzwi przed cyberprzestępcami.
Złośliwe oprogramowanie zawarte w komponentach open source nie powinno niweczyć ogromnych korzyści, jakie społeczność open source przyniosła naszemu społeczeństwu.
- [1] Nasz skaner wykrywa komponenty open source, do których odwołują się analizowane projekty oprogramowania, dzięki czemu znany jest pełny, aktualny graf zależności, przynajmniej w przypadku projektów regularnie skanowanych. Oprogramowanie Xygeni OSS udostępnia interfejs API, z którego klienci mogą również korzystać podczas dodawania interesującego ich komponentu do białej listy, zawierający informacje o lukach w zabezpieczeniach i dowodach złośliwego oprogramowania.
- [2] Zabezpieczenie może przerwać kompilację, jeśli zostanie wykryty stan odpowiadający problemom bezpieczeństwa. Odkrycia dotyczące bezpieczeństwa, takie jak krytyczna i dostępna luka w zabezpieczeniach lub użycie komponentu poddanego kwarantannie, mogą zostać uznane za na tyle poważne, że przerwałyby kompilację dla danego oprogramowania.
- [3]Nasi analitycy bezpieczeństwa uruchamiają komponent lub jego skrypty instalacyjne w środowisku sandboxowym, gdy jest to konieczne. MEW nie przeprowadza jednak analizy dynamicznej, głównie dlatego, że złośliwe zachowanie nie zawsze występuje w atakach ukierunkowanych, a także ze względu na logikę unikania, którą stosują atakujący, aby uniknąć analizy dynamicznej.
- [4] Technice tej nadano nazwę „Algorytmy Generowania Domen Zarejestrowanych” lub RDGA, a nowi aktorzy zagrożeń, tacy jak tzw. Rewolwerowy Królik zainwestowano aż 1 mln USD w 500 tys. domen, co pokazuje, jak dochodowy jest przemysł cyberprzestępczości.
