







უნარების ფაილი. წესების ფაილი. MCP სერვერის კონფიგურაცია. სამი სტრიქონი უბრალო ტექსტი, commitდოკუმენტაციასავითაა დამუშავებული, დოკუმენტაციასავითაა განხილული და არცერთი მათგანი კოდს არ ჰგავს. და მაინც, თითოეულ მათგანს შეუძლია ჩუმად გადაწეროს ის, რისი გაკეთებაც თქვენს ხელოვნურ ინტელექტთან დაკავშირებულ ასისტენტს და რაზე წვდომა აქვს. ეს არის არასასიამოვნო სიმართლე, რომელიც ხელოვნური ინტელექტის უსაფრთხოების მიღმა დგას. წელს 2026ინდუსტრიამ ორი წელი გაატარა იმაზე ფიქრში, თუ რას შეიცავს ხელოვნური ინტელექტის მიერ გენერირებული კოდი. უფრო რთული პრობლემა თავად ხელოვნური ინტელექტის მიწოდების ჯაჭვი აღმოჩნდა: მოდელები, აგენტები, MCP სერვერები და კონფიგურაციის ფაილები, რომლებიც ახლა თქვენი საწყისი კოდისა და ღია კოდის დამოკიდებულებების გვერდით დევს, ძირითადად ინვენტარიზებული და გადაუმოწმებელი. სწორედ ამიტომ გახდა ხელოვნური ინტელექტის მიწოდების ჯაჭვის უსაფრთხოება დამოუკიდებელი დისციპლინა და ამიტომ მნიშვნელოვანია ხელოვნური ინტელექტის უსაფრთხოების სწორი კომპანიის არჩევა ისევე, როგორც სწორი სკანერის არჩევა.
თავდასხმის ზედაპირი, რომლისთვისაც არავინ იყო განკუთვნილი
პროგრამულ უზრუნველყოფას ადრე ჰქონდა რამდენიმე ადგილი, სადაც თავდამსხმელს შეეძლო მოხვედრა: კოდი, დამოკიდებულებები, pipelineხელოვნურმა ინტელექტმა კიდევ ორი დაამატა და ორივე პირდაპირ ხელოვნური ინტელექტის მიწოდების ჯაჭვში შედის.
მოდელი და აგენტი. ხელსაწყოებით მოწამვლა, სწრაფი ინექცია, აგენტის ავტონომია, რომელიც ნებისმიერს ჩაფიქრებულზე მეტს აღწევს. MCP სერვერის აღწერილობაში დამალულ ინსტრუქციას შეუძლია ჩუმად გადაამისამართოს თანაპილოტის მოქმედება და დეველოპერი ამას ვერასდროს ამჩნევს.
დეველოპერის საკუთარი გარემო. IDE-ები, ხელოვნური ინტელექტის თანაპილოტები, MCP სერვერები, აგენტის CLI-ები. უხილავია მემკვიდრეობით მიღებული AppSec სკანერებისთვის, რომლებმაც არ იციან, რა არის მოდელი და უხილავია EDR-ისთვის, რომელიც აკვირდება ოპერაციულ სისტემას და წარმოდგენა არ აქვს, რა არის დამოკიდებულება ან MCP ზარი.
ეს ყველაფერი თეორიულად არ არის დასაბუთებული. ბოლო თვრამეტი თვის განმავლობაში:
- დამალული Unicode-ის „წესების ფაილის უკანა კარი“ თავდამსხმელებს საშუალებას აძლევდა Copilot-ისა და Cursor-ის მიერ წაკითხულ კონფიგურაციის ფაილებში უხილავი ინსტრუქციები შეეყვანათ, რითაც ჩუმად შეიჭრნენ ასისტენტის მიერ გენერირებული კოდი. GitHub-მა ამის შესახებ გაფრთხილება 2025 წელს დაამატა.
- პოპულარულ MCP ხიდში (CVSS 9.6) ბრძანების ინექციის ხარვეზმა 400 000-ზე მეტი ჩამოტვირთვა განიცადა, სანამ გამოსწორდებოდა. ეს იყო პირველი დოკუმენტირებული შემთხვევა, როდესაც კოდის სრული დისტანციური შესრულება უბრალოდ არასანდო MCP სერვერთან დაკავშირებით მოხდა.
- თვითგავრცელებულმა npm ჭიამ დეველოპერები თავად გადააქცია მიწოდების მექანიზმად და ეს სქემა მომდევნო თვეებში მასშტაბურად განმეორდა სხვა ეკოსისტემებში, რაც ხელოვნური ინტელექტის მიწოდების ჯაჭვის უსაფრთხოების სახელმძღვანელოს მსგავსი ჩავარდნაა.
- მკვლევრებმა აღმოაჩინეს, რომ სამართლის მაგისტრების მიერ რეკომენდებული პაკეტების მნიშვნელოვანი ნაწილი საერთოდ არ არსებობს, ეს არის „დაუმუშავებელი“ სახელები, რომლებსაც თავდამსხმელი რეგისტრირდება მანამ, სანამ რეალური დეველოპერი მოდელს მათ იმპორტირებას სთხოვს.
Google-ის მიერ ხელოვნური ინტელექტის პროგრამული უზრუნველყოფის მიწოდების ჯაჭვის უსაფრთხოების შესახებ ჩატარებული კვლევა მსგავს დასკვნამდე მივიდა სხვა კუთხით: 2023 და 2024 წლებში აღმოჩენილი მოდელები ლეგიტიმურად გამოიყურებოდნენ, თუმცა შეიცავდნენ კოდს, რომელსაც შეეძლო მონაცემების ამოღება ან ჩამოტვირთვის შემდეგ „უკანა კარის“ დამონტაჟება, ხოლო გამოსწორება არ იყო ახალი კატეგორიის ინსტრუმენტი, არამედ მიწოდების ჯაჭვის დისციპლინის გამოყენება, როგორიცაა წარმომავლობა და ხელმოწერა, იმ არტეფაქტებზე, რომლებსაც აქამდე არავინ აკონტროლებდა. ეს არის ხელოვნური ინტელექტის მიწოდების ჯაჭვის უსაფრთხოების პრობლემა ერთი წინადადებით: არტეფაქტები ახალია, მაგრამ მათთვის საჭირო დისციპლინა - არა.
რატომ მთავრდება თქვენი არსებული ხელსაწყოები
SAST კოდს კითხულობს. SCA კითხულობს დამოკიდებულებების მანიფესტს. არცერთმა არ იცის, რა არის მოდელი, რას ავლენს MCP სერვერი ან რას ავალებს უნარების ფაილი აგენტს. სწორედ ეს ხარვეზია, სადაც ხელოვნური ინტელექტის ეპოქის შეტევები ხდება, „ჩვენს მიერ სკანირებულ კოდსა“ და „ჩუმად მიღებულ ხელოვნურ ინტელექტს“ შორის არსებულ სივრცეში.
შედეგი არის ჩრდილის ხელოვნური ინტელექტის კატეგორია არა CISამჟამად O-ს შეუძლია პასუხის გაცემა შემდეგ კითხვებზე: რა მოდელებს ვიყენებთ, რომელ აგენტებს შეუძლიათ რაზე წვდომა და რომელ MCP სერვერს დაუკავშირდა ვინმე გასულ სამშაბათს ვინმეს არავისთვის უთქვამს. ამ კითხვაზე კარგად პასუხის გაცემა ხელოვნური ინტელექტის მიწოდების ჯაჭვის უსაფრთხოების საქმეა და სწორედ ეს არის მიზეზი, რის გამოც ზოგადი AppSec ინსტრუმენტები აქ არასაკმარისია.
რას ნიშნავს სინამდვილეში ხელოვნური ინტელექტის უსაფრთხოება
ქსიგენი არის ხელოვნური ინტელექტის უსაფრთხოების კომპანია, რომელიც ამას სამ დაკავშირებულ მოძრაობად განიხილავს SDLC: აღმოჩენა, აღმოჩენა და აღსრულება.
აღმოაჩინეთ: იცოდეთ, რა ხელოვნური ინტელექტი გაქვთ სინამდვილეში
თქვენს საცავებში უწყვეტი, ავტომატური აღმოჩენა ავლენს ყველა ხელოვნური ინტელექტის აქტივს: მოდელებს, ჩარჩოებს, მონაცემთა ნაკრებებს, დასკვნის საბოლოო წერტილებს, აგენტებს, MCP სერვერებს, უნარებს, მოთხოვნებს და guardrailsდა ხელოვნური ინტელექტის კოდირების ინსტრუმენტები, რომლებსაც თქვენი დეველოპერები რეალურად იყენებენ. არანაირი გამოკითხვა. არანაირი თვითშეფასება. თუ ის კვალს დატოვებს საცავში, ის ინვენტარში აისახება, რაც ხელოვნური ინტელექტის მიწოდების ჯაჭვის რეალური უსაფრთხოების პირველი და ყველაზე ძირითადი მოთხოვნაა.
შემდეგ ხელოვნური ინტელექტის გრაფიკი ასახავს, თუ როგორ უკავშირდება ეს აქტივები ერთმანეთს: რომელ მოდელს აწვდის მონაცემთა ნაკრები, რომელი აგენტი იყენებს რომელ ინსტრუმენტს, რომელი MCP სერვერი რომელი ასისტენტის უკან დგას. იზოლირებული აქტივი ცოტას გეუბნებათ. გრაფიკი გიჩვენებთ, თუ სად არის რისკი კონცენტრირებული.
იმავე აღმოჩენიდან, Xygeni წარმოქმნის AI-BOM: თქვენს პროგრამულ უზრუნველყოფაში ხელოვნურ ინტელექტთან დაკავშირებული ყველაფრის აუდიტისთვის მზა, მანქანური წასაკითხი ინვენტარი. როდესაც მარეგულირებელი ორგანო, აუდიტორი ან მომხმარებელი გეკითხებათ, რომელ ხელოვნურ ინტელექტს იყენებთ, პასუხი სამკვირიანი აჩქარების ნაცვლად ჩამოტვირთვა ხდება.
აღმოჩენა: რისკები, რომლებსაც ჩვეულებრივი სკანერები ვერ ხედავენ
ხელოვნური ინტელექტის სპეციალური სკანერი ეძებს ხელოვნური ინტელექტის სისტემებისთვის დამახასიათებელ ჩავარდნის რეჟიმებს: სწრაფი ინექცია, ხელსაწყოს ინექცია და არასანდო ხელსაწყოს გამოძახება, მონაცემთა გაჟონვა აღდგენის გზით, სისტემის სწრაფი გვერდის ავლა, გადაჭარბებული აგენტობა. ყველა აღმოჩენა შეესაბამება OWASP-ის ტოპ 10 LLM აპლიკაციებისთვის და მიუთითებს ზუსტ ფაილსა და სტრიქონზე, რომელიც ქმნის ექსპოზიციას და არა ბუნდოვან შეტყობინებაზე „გადახედეთ თქვენი ხელოვნური ინტელექტის გამოყენებას“.
იგივე აღმოჩენის ფენა უნარების ფაილებს, წესების ფაილებს და MCP კონფიგურაციებს უსაფრთხოების არტეფაქტებად და არა უვნებელ დოკუმენტაციად მიიჩნევს. ის აღნიშნავს მავნე ან მოწამლულ უნარებს, ამოწმებს MCP სერვერის კონფიგურაციებს ხელსაწყოების მოწამვლაზე და აჩვენებს მოთხოვნებს, რომლებიც რეალურად ამუშავებს თქვენს ხელოვნური ინტელექტის სამუშაო დატვირთვას.
პრიორიტეტი მიანიჭეთ: ძაბრს, რომელიც ხმაურს ამცირებს და არა კუთხეებს
ყველა აღმოჩენა თანდათანობით იფილტრება: აპლიკაციის კოდში ხელმისაწვდომ ადგილებამდე, შემდეგ რეალურად ექსპლუატირებად ადგილებამდე და ბოლოს, კოდში არსებულ ადგილებამდე, რომელსაც თქვენი გუნდი აქტიურად ავითარებს. დეველოპერის რიგში მხოლოდ ის მოკლე სია ხვდება, რომელიც რეალურად საფრთხეს უქმნის წარმოებას, ჩარჩოს მითითებით, ექსპოზიციის ფანჯრით და შერბილების ინსტრუქციებით.
აღსრულება: შეაჩერე სანამ გაშვებას დაიწყებს
Shield პოლიტიკის აღსრულებას დეველოპერის საკუთარ საბოლოო წერტილამდე მიჰყავს: ის ბლოკავს არაავტორიზებული და მავნე ინსტალაციების, დაუმტკიცებელი მოდელების და დაუმტკიცებელი MCP სერვერების მოქმედებას, სანამ რამე შესრულდება. მის ქვეშ დევს Xygeni-ს მავნე პროგრამების ადრეული გაფრთხილება (MEW), რომელიც მავნე პაკეტებს ხელმოწერის არსებობამდე იჭერს, ფენის რეპუტაციაზე დაფუძნებული ინსტრუმენტები კვლავ სანდოა, რადგან ჯერ არავის შეუტყობინებია პაკეტის შესახებ. ეს ხელოვნური ინტელექტის მიწოდების ჯაჭვის უსაფრთხოების აღსრულების ნახევარია: აღმოჩენა და აღმოჩენა გეუბნებათ, რა არის არასწორი, Shield რაც რეალურად აჩერებს.
თქვენი ხელოვნური ინტელექტის ექსპოზიცია მხოლოდ თქვენს ხელოვნური ინტელექტის კოდში არ არის
ხელოვნური ინტელექტის მიწოდების ჯაჭვის უსაფრთხოების სრული სურათის შესაქმნელად მოდელების ინვენტარიზაციაზე მეტია საჭირო და იშვიათად არის საქმე მხოლოდ თვალშისაცემი დეტალებით:
- ხელოვნური ინტელექტის პროვაიდერის სერთიფიკატები დარჩა მოთხოვნის ფაილებში, აგენტის კონფიგურაციებში ან pipeline ჟურნალები ისეთივე საიდუმლოა, როგორც ნებისმიერი სხვა და Xygeni-ის საიდუმლოებების აღმოჩენა მათ საჯარო რეესტრში მოხვედრამდე აფიქსირებს.
- დაუცველი ხელოვნური ინტელექტისა და მანქანური სწავლების დამოკიდებულებები ჩვეულებრივი CVE-ები, რომლებიც გამოვლინდა იმავე პროგრამული უზრუნველყოფის შემადგენლობის ანალიზით, რომელიც უკვე მოიცავს თქვენი სტეკის დანარჩენ ნაწილს. ხელოვნური ინტელექტის დანერგვის შესახებ მესამე მხარის კვლევამ აჩვენა, რომ თანამედროვე ხელოვნური ინტელექტის სტეკის დიდი ნაწილი გარე წყაროებიდან მოპოვებული პაკეტები და ფარული კომპონენტებია, რაც ზუსტად ისაა, რისი დაფარვაც პროგრამული უზრუნველყოფის შემადგენლობის ზედაპირული ანალიზის მიერ იყო შექმნილი.
- მავნე პაკეტები გამოქვეყნდა ნებისმიერ საკონსულტაციო რეკომენდაციაზე სწრაფად pipeline შეგიძლიათ მათი კატალოგიზაცია ხელმოწერამდე, იგივე MEW შესაძლებლობა იცავს თქვენი მიწოდების ჯაჭვის დანარჩენ ნაწილს.
აგენტური ფენა: DevAI და CoreAI
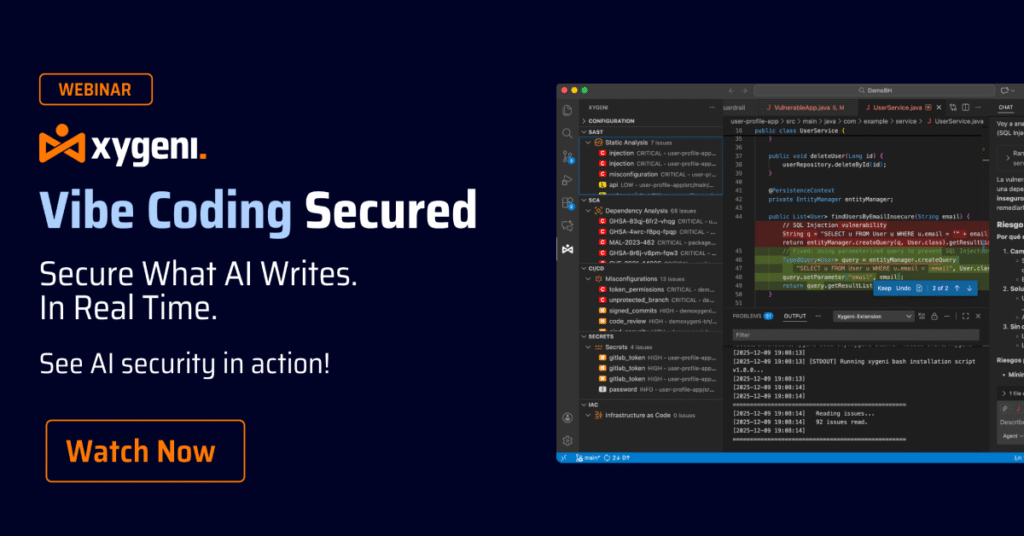
აღმოჩენა და აღმოჩენა მოიცავს იმას, რაც უკვე არის თქვენს საცავებში. DevAI მუშაობს იქ, სადაც რისკი იქმნება: IDE-ს შიგნით, როგორც უწყვეტი, პროაქტიული ფენა, რომელიც სკანირებს ადამიანისა და ხელოვნური ინტელექტის მიერ გენერირებულ კოდს მისი დაწერისთანავე, არანაირი მოთხოვნა არ არის საჭირო. ის განმარტავს აღმოჩენის უკან მდგომ სრულ ექსპლოიტის გზას და გვთავაზობს MCP-დადასტურებულ გამოსწორებებს, რომელთა გამოყენებაც დეველოპერს შეუძლია თავდაჯერებულად, ბილდის დარღვევის გარეშე.
CoreAI ინდივიდუალური სკანერების ზემოთ დგას, როგორც ინტელექტის ფენა: ის აკავშირებს კოდს, დამოკიდებულებას, pipelineდა პოზიციის მონაცემებს ერთ რისკის მოდელად აერთიანებს, პასუხობს კითხვებს ბუნებრივი ენით და ქმნის აღმასრულებელი დირექტორისთვის მზა ანგარიშს, რომელიც უსაფრთხოების ლიდერს სჭირდება იმის საჩვენებლად, რომ მმართველობა რეალურად ხდება და არა მხოლოდ მტკიცებით.
გააფართოვეთ ის, რაც გაქვთ AI Security-ში. არაფერი ამოიღოთ
ახალი უსაფრთხოების კატეგორიის ყველაზე გავრცელებული წინააღმდეგობაა „ჩვენ უკვე საკმარისი ინსტრუმენტები გვაქვს“. როგორც ხელოვნური ინტელექტის უსაფრთხოების კომპანია, Xygeni არ გთხოვთ არაფრის შეცვლას: იგივე დახარისხება, ახსნა და პრიორიტეტიზაცია, რომელიც გამოიყენება საკუთარ დასკვნებზე, თანაბრად მოქმედებს თქვენი არსებული დასკვნებზე. SAST, SCAდა მესამე მხარის სკანერები. თქვენი ამჟამინდელი სტეკი ხდება შემავალი ფაქტორი და არა მსხვერპლი, ხოლო თქვენი ხელოვნური ინტელექტის მიწოდების ჯაჭვის უსაფრთხოების მდგომარეობა უმჯობესდება „ამოღების და ჩანაცვლების“ პროექტის გარეშე.
რატომ არის ეს მნიშვნელოვანი ახლა და არა მოგვიანებით
მარეგულირებლები სხვადასხვა მიმართულებით ერთი და იგივე მოლოდინზე თანხვედრაში არიან: ევროკავშირის ხელოვნური ინტელექტის შესახებ კანონი, NIS2 და ესპანეთის ENS ყველა ხელოვნური ინტელექტის სისტემების ინვენტარიზაციისა და მიკვლევადობისკენ ისწრაფვის, იგივე მტკიცებულებების, რის წარმოსაქმნელადაც AI-BOM არის შექმნილი. მოძრაობის მიმართულება ნათელია მაშინაც კი, როდესაც ზუსტი შესაბამისობის მექანიზმები ჯერ კიდევ არ არის დადგენილი: თქვენ არ შეგიძლიათ დაადასტუროთ ხელოვნური ინტელექტი, რომლის ინვენტარიზაციაც არასდროს გაგიკეთებიათ და ვერც აცხადებთ ხელოვნური ინტელექტის მიწოდების ჯაჭვის უსაფრთხოებაზე პრეტენზიას, თუ თავად მიწოდების ჯაჭვი თქვენთვის უხილავია.
ხელოვნური ინტელექტის უსაფრთხოების კომპანიის არჩევა
ყველა ხელოვნური ინტელექტის უსაფრთხოების კომპანია ერთსა და იმავე ადგილას არ ავლენს თავის საზღვრებს. ზოგი მხოლოდ თქვენივე ხელოვნური ინტელექტის მიერ გენერირებული კოდის სკანირებით ჩერდება. სხვები კი საბოლოო წერტილში ჩერდებიან. ხელოვნური ინტელექტის მიწოდების ჯაჭვის უსაფრთხოების საკითხი უფრო დიდია, ვიდრე თითოეული ცალკეული ნაწილის სკანირება: ის მოიცავს მოდელს, აგენტს, MCP სერვერს, უნარების ფაილს და ჩვეულებრივ დამოკიდებულებას, რომელიც ამ ყველაფრის ქვეშაა მოთავსებული. ხელოვნური ინტელექტის უსაფრთხოების კომპანიის შეფასებისას, სრული სასიცოცხლო ციკლის ხედი, აღმოჩენიდან აღსრულებამდე, ერთ კონსოლში, თქვენი AppSec-ის დანარჩენ დასკვნებთან ერთად, არის ის, რასაც უნდა მიაქციოთ ყურადღება და არა მხოლოდ ერთ წერტილოვან ინსტრუმენტზე.
ფაილები, რომლებსაც არავინ ამოწმებდა, მათი შეღწევის გზად იქცა. ხელოვნური ინტელექტის უსაფრთხოება მათი განხილვის დისციპლინაა და ხელოვნური ინტელექტის მიწოდების ჯაჭვის უსაფრთხოება სწორედ ის არის, რაც ამ დისციპლინას ბოლომდე ამართლებს, იმავე პლატფორმაზე, სადაც თქვენ უკვე ყველაფერს ამოწმებთ.
ნახეთ, სინამდვილეში რისი გაკეთება შეუძლია თქვენს ხელოვნურ ინტელექტს. დაიწყეთ უფასოდ or დანიშნოს დემო.

კითხვა-პასუხი
Xygeni-ის კოდი ოდესმე ტოვებს ჩემს ინფრასტრუქტურას?
არა. სკანირება თქვენს გარემოში ხორციელდება და საწყისი კოდი არასდროს იტვირთება Xygeni-ს სერვერებზე. ხელოვნური ინვენტარი და AI-BOM აგებულია სკანერის მიერ ადგილობრივად დანახული მონაცემების საფუძველზე და არა გარედან გაგზავნილი ასლის საფუძველზე.
რა განსხვავებაა AI Security-ს, DevAI-სა და CoreAI-ს შორის?
AI Security აღმოაჩენს და ამოიცნობს: ის ქმნის AI ინვენტარს, AI-BOM-ს და პოულობს რისკებს, როგორიცაა სწრაფი ინექცია ან მოწამლული უნარების ფაილები. DevAI მუშაობს IDE-ში, როდესაც დეველოპერები წერენ კოდს და გვთავაზობს გამოსწორებებს მუშაობის პროცესში. CoreAI ორივეზე მაღლა დგას, აკავშირებს მთელ პლატფორმაზე დასკვნებს და პასუხობს თქვენი უსაფრთხოების მდგომარეობის შესახებ კითხვებს ბუნებრივი ენით.
რომელ ხელოვნური ინტელექტის უსაფრთხოების ჩარჩოებს შეესაბამება Xygeni?
შედეგები შეესაბამება OWASP-ის ტოპ 10-ს LLM აპლიკაციებისთვის, OWASP-ის ტოპ 10-ს MCP-სთვის და OWASP-ის ტოპ 10-ს აგენტის უნარებისთვის, NIST SP 800-218A-სთან ერთად. CISA/G7 სახელმძღვანელო ხელოვნური ინტელექტის მასალების ჩამონათვალის შესახებ. სწორედ ეს რუკები ხდის AI-BOM-ს შესაბამისობის მტკიცებულებად გამოსაყენებელს და არა მხოლოდ ინვენტარის სახით.
ეს ყველა ხელოვნური ინტელექტის ბიბლიოთეკას ან მოდელს რისკის ნიშნად მონიშნავს?
არა. პრიორიტეტების განსაზღვრის ძაბრი აღმოჩენებს ავიწროებს აპლიკაციის კოდში ხელმისაწვდომ, ნამდვილად ექსპლუატირებად და აქტიურ შემუშავებაში მყოფ მონაცემებამდე, ამიტომ დეველოპერის მიერ ხილული სია მოკლეა და არა ყველა აღმოჩენილი ხელოვნური ინტელექტის აქტივის ნაკრები.
