






რვა თვე. ოთხი მნიშვნელოვანი ინციდენტი. ერთი კანონზომიერება: პროგრამული უზრუნველყოფის მიწოდების ჯაჭვმა ახალი მოწინააღმდეგე კი არა, ახალი იარაღი მიიღო. 2025 წლის სექტემბრიდან 2026 წლის მაისამდე თვითგავრცელებადი ჭია, ეროვნული სახელმწიფოს აქტორი, კოპირების კამპანია და გატაცებული ხელოვნური ინტელექტის მოდელი მოხვდა. pipelineრომელსაც მილიონობით დეველოპერი ყოველდღიურად ენდობა. ეს კიბერუსაფრთხოების საფრთხეების ახალი ფორმაა: უფრო სწრაფი, უფრო ძნელად შესამჩნევი და სულ უფრო მეტად იმავე ხელოვნური ინტელექტით აღჭურვილი, რომელსაც დეველოპერების გუნდები კოდის გასაგზავნად იყენებენ.
თუ კიბერუსაფრთხოების საფრთხეების თქვენი გონებრივი მოდელი მაინც იწყება და მთავრდება ფიშინგური ელფოსტით და გაუმართავი სერვერებით, ქვემოთ მოცემული მონაცემები განაახლებს მას.
კიბერუსაფრთხოების საფრთხეების ახალი ფორმა
წლების განმავლობაში კიბერუსაფრთხოების საფრთხეები ნიშნავდა მოპარულ ავტორიზაციის მონაცემებს, არასწორად კონფიგურირებულ სერვერებს და სოციალურ ინჟინერიას. ეს რისკები არ გამქრალა: 2022 წელს დადასტურებული მონაცემთა დარღვევის 81% კომპრომეტირებულ ავტორიზაციის მონაცემებს ეხებოდა. თუმცა, საუბრის ცენტრში ახალი კატეგორია გადავიდა: ხელოვნური ინტელექტის საფრთხეები. განვითარების გუნდები ახლა ხელოვნური ინტელექტის კოდირების ასისტენტებზე, აგენტ-თანამებრძოლებზე და... მოდელის კონტექსტური პროტოკოლი (MCP) სერვერები პროგრამული უზრუნველყოფის უფრო სწრაფად შესაქმნელად და თითოეული მათგანი ახლა სამიზნეა. კვლევები აჩვენებს, რომ ხელოვნური ინტელექტის მიერ გენერირებული კოდის დაახლოებით 40% შეიცავს უსაფრთხოების ხარვეზებს, რაც იმას ნიშნავს, რომ ხელოვნური ინტელექტის მიერ დაპირებულ სიჩქარეს თან ახლავს კოდის ბაზაში პირდაპირ ჩადებული ხელოვნური ინტელექტის უსაფრთხოების რისკების პროპორციული ზრდა.
რვა თვე, ოთხი ინციდენტი: როგორ გაიზარდა ხელოვნური ინტელექტის საფრთხეები
ხელოვნური ინტელექტის საფრთხეების აჩქარების ყველაზე ნათელი მტკიცებულება არ არის პროგნოზი; ეს არის უკვე მომხდარის ქრონოლოგია:
- 2025 წლის სექტემბერი, შაი-ჰულუდი: პირველი თვითგავრცელებადი npm ჭია, რომელიც თავად დეველოპერებს მიწოდების მექანიზმად აქცევს.
- 2026 წლის მარტი, axios: პაკეტში დამალული ეროვნული-სახელმწიფოებრივი მავნე პროგრამა, რომელიც კვირაში დაახლოებით 100 მილიონჯერ იჭრება.
- 2026 წლის აპრილი, SAP npm: იგივე ჭიის ნიმუშის უფრო მცირე მასშტაბის გამეორება, რომელიც აჩვენებს ტექნიკის მასშტაბებს.
- 2026 წლის მაისი, კლოდ ოპუსი → PromptMink: დიდი ენობრივი მოდელი, რომელიც გამოიყენება ავტონომიურ აგენტში მავნე პროგრამების ჩასანერგად, სადაც თავად ხელოვნური ინტელექტი მოქმედებს როგორც შეტევის ვექტორი.
თითოეული ინციდენტი წინას ხელახლა იყენებდა და მასშტაბირებდა. ეს არის ხელოვნური ინტელექტის საფრთხეების განმსაზღვრელი მახასიათებელი 2026 წელს: ისინი უფრო სწრაფად მრავლდებიან, ვიდრე ტრადიციული კიბერუსაფრთხოების საფრთხეები ოდესმე, რადგან იგივე ავტომატიზაცია, რომელიც დეველოპერებს ეხმარება, ასევე ეხმარება თავდამსხმელებს გავრცელებაში.
რატომ ვერ ხედავენ ტრადიციული ხელსაწყოები ხელოვნური ინტელექტის ამ რისკებს
ტრადიციული AppSec ინსტრუმენტები საცავში ჩერდება და არ იცის, რა არის მოდელი. ტრადიციული საბოლოო წერტილების ინსტრუმენტები აკვირდებიან ოპერაციულ სისტემას და არ ესმით პაკეტები, MCP სერვერები ან ხელოვნური ინტელექტის ასისტენტები. სწორედ ეს ხარვეზია ამ ორს შორის, სადაც ხელოვნური ინტელექტი რისკავს, შეუმჩნევლად, სანამ ზიანს არ მიაყენებენ.
ორი ციფრი ამხელს ფაქტს: ხელოვნური ინტელექტით მიზნობრივი ავტორიზაციის ქურდობა 2025 წლის მეოთხე კვარტალსა და 2026 წლის პირველ კვარტალს შორის 376%-ით გაიზარდა, ხოლო ერთი მავნე MCP ხიდი (CVE-2025-6514) 437,000-ჯერ იქნა გადმოწერილი, სანამ ის აღმოჩენილი იქნებოდა, რამაც კლიენტზე კოდის დისტანციურად შესრულების საშუალება მისცა. საჯარო MCP სერვერებიც ნაგულისხმევად უსაფრთხო არ არის: 5.5%-ს ხელსაწყოების მავნე ზემოქმედების ხარვეზები აქვს, ხოლო 43%-ს ბრძანების ინექციის ხარვეზები, რომლებიც იმდენად სერიოზულია, რომ დეველოპერის საკუთარი ხელსაწყოები ორგანიზაციისთვის კიბერუსაფრთხოების ერთ-ერთ ყველაზე სერიოზულ საფრთხედ აქცევს.
პროგრამული უზრუნველყოფის მიწოდების ჯაჭვი კვლავ კიბერუსაფრთხოების საფრთხეების ყველაზე დიდი წყაროა
ხელოვნურმა ინტელექტმა ეს პრობლემა არ გამოიგონა, მან გააფართოვა. პროგრამული უზრუნველყოფის მიწოდების ჯაჭვი ისედაც კიბერუსაფრთხოების საფრთხეების ყველაზე ექსპლუატირებული შესვლის წერტილი იყო და ამას ციფრებიც ადასტურებს. 2019 წლიდან 778,500-ზე მეტი მავნე ღია კოდის პაკეტი იქნა აღმოჩენილი და ეს მაჩვენებელი ერთ წელიწადში 156%-ით გაიზარდა და 512,847 პაკეტს მიაღწია. ENISA-მ დაადგინა, რომ მიწოდების ჯაჭვის შეტევების 60%-მა ისარგებლა მომხმარებლის ნდობით მომწოდებლის მიმართ და ზოგიერთი შეფასებით, პროგრამული უზრუნველყოფის მიწოდების ჯაჭვი ამჟამად შეტევას დაახლოებით ყოველ 48 საათში განიცდის. მიწოდების ჯაჭვის შეტევები 2019-დან 2022 წლამდე 742%-ით გაიზარდა, პროგნოზებით, ორგანიზაციების 45% დაზარალდება 2025 წლისთვის და წლიური ხარჯები 2031 წლისთვის 138 მილიარდ დოლარს მიაღწევს; მხოლოდ წელს პროგრამული უზრუნველყოფის მიწოდების ჯაჭვის შეტევების ღირებულება 60 მილიარდ დოლარად არის შეფასებული.
იგივე დამოკიდებულება და pipeline სისუსტეები, რომლებმაც შექმნეს ეს კლასიკური კიბერუსაფრთხოების საფრთხეები, ახლა ხელოვნური ინტელექტის რისკებსაც შეიცავს: კომპრომეტირებული პაკეტი, არასწორად კონფიგურირებული GitHub მოქმედება ან მოხსნილი... CI/CD step-ს შეუძლია ხელოვნური ინტელექტის აგენტის მიზანში ამოღება ისევე მარტივად, როგორც ადამიანი დეველოპერის.
კოდურ ბაზას მიღმა ხელოვნური ინტელექტის უსაფრთხოების უფრო ფართო რისკები
ყველა ხელოვნური ინტელექტის რისკი კოდის ფაილში არ ინახება. ხელოვნური ინტელექტის უსაფრთხოების რისკების უფრო სრულყოფილი რუკა მოიცავს ხელოვნური ინტელექტის აქტივის მთელ სასიცოცხლო ციკლს: სწრაფი ინექცია და სისტემიდან სწრაფი გაჟონვა, მგრძნობიარე მონაცემები, რომლებიც გამჟღავნებულია ზედმეტად ნებადართული ხელოვნური ინტელექტის კონფიგურაციებით, მოწამლული ვექტორები და ჩაშენებები, დოკუმენტებსა და წესების ფაილებში დამალული მავნე ინსტრუქციები, დაუცველი MCP კონფიგურაციები და არასანდო სერვერები, დაუცველი ან დაუდევრად დაცული ხელოვნური ინტელექტის დამოკიდებულებები და გადაჭარბებული აგენტობა, სადაც ხელოვნური ინტელექტის აგენტი მოქმედებს იმ საზღვრებს მიღმა, რომლითაც ის იყო კონფიგურირებული.
ეს კატეგორიები პირდაპირ კავშირშია OWASP-ის ტოპ 10 LLM აპლიკაციებისთვისსაქართველოს OWASP-ის ტოპ 10 აგენტური აპლიკაციებისთვისდა OWASP MCP ტოპ 10სამი ჩარჩო, რომელიც სწრაფად გახდა ინდუსტრიაში ხელოვნური ინტელექტის უსაფრთხოების რისკების საერთო ლექსიკონად.
კიბერუსაფრთხოების საფრთხეების შემცირება: რა მუშაობს სინამდვილეში
მონაცემები მიუთითებს ორ რამეზე, რაც თანმიმდევრულად მუშაობს კიბერუსაფრთხოების საფრთხეების წინააღმდეგ: ძირითადი ჰიგიენა და ადრეული გამოვლენა. კიბერშეტევების 98%-ის თავიდან აცილება ძირითადი უსაფრთხოების ჰიგიენით ხდება, თუმცა მონაცემთა დარღვევის 34% მაინც შინაგანი საფრთხეებიდან მოდის და აპლიკაციების 60% კვლავ შეიცავს დაუცველობას პირველი მხარის კოდში. თავად GitHub არ არის დაზღვეული: GitHub-ის ექსპლოიტის კონცეფციის დამადასტურებელი საცავების 1.9% თავად არის მავნე, შექმნილი მონაცემების მოსაპარად ან მავნე პროგრამების განსათავსებლად იმ მკვლევარებისთვის, რომლებიც მათ ენდობიან.
კონკრეტულად ხელოვნური ინტელექტის რისკებისთვის, გამოსწორება სასიცოცხლო ციკლის უფრო ადრეულ ეტაპზე უნდა განხორციელდეს:
- დაადასტურეთ IDE-ში. ხელოვნური ინტელექტის მიერ გენერირებულ კოდში დაუცველი შაბლონების დაფიქსირება მანამ, სანამ ის ოდესმე მიაღწევს pipeline ხურავს ხელოვნური ინტელექტის ახალი უსაფრთხოების რისკების ყველაზე დიდ ერთადერთ წყაროს.
- ხელმოწერის არსებობამდე მავნე პროგრამის აღმოჩენა. რეპუტაციაზე დაფუძნებული ინსტრუმენტები, განმარტებით, ნულოვანი დღის პაკეტებს აკლია, რაც ზუსტად ის ხარვეზია, რომელსაც Shai-Hulud, axios და SAP npm იყენებდნენ.
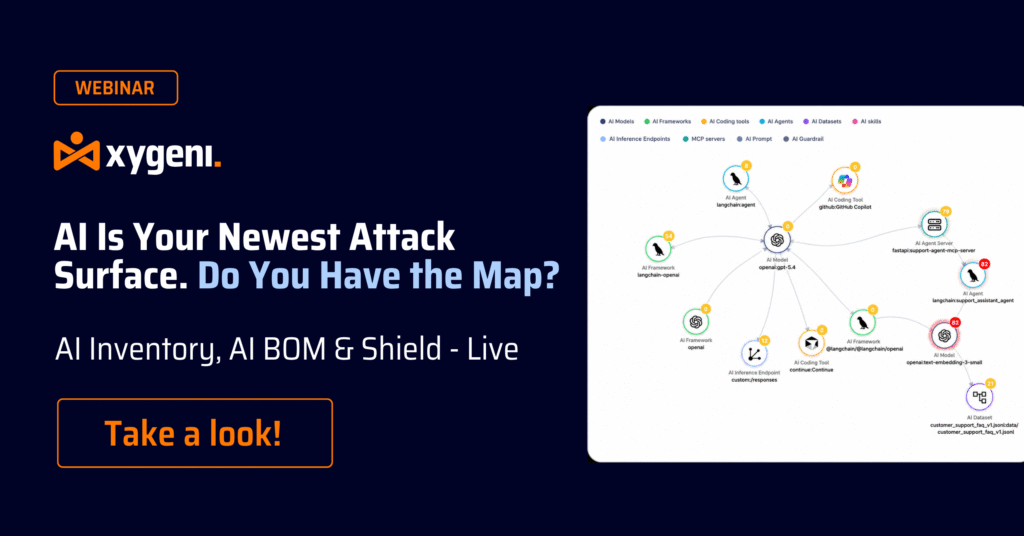
- ინვენტარიზაცია გაუკეთეთ ყველა ხელოვნური ინტელექტის აქტივს. მოდელების, მონაცემთა ნაკრებების, აგენტებისა და MCP სერვერების მართვა ან მათზე თავდასხმა შეუძლებელია ისეთი რამის მეშვეობით, რისი გაშვებაც გუნდმა არ იცის.
როგორ უმკლავდება Xygeni კიბერუსაფრთხოების ამ საფრთხეებს
ქსიგენი ხელოვნური ინტელექტის საფრთხეებს აპლიკაციის უსაფრთხოების პირველი კლასის ნაწილად მიიჩნევს და არა ცალკე პრობლემად, რომელიც შემდგომში ჩნდება. DevAI რეალურ დროში უსაფრთხოების ვალიდაციას ახორციელებს დეველოპერის IDE-ში და გამოშვებამდე აფიქსირებს დაუცველ ნიმუშებს ხელოვნური ინტელექტის მიერ გენერირებულ კოდში. მავნე პროგრამების ადრეული გაფრთხილება (MEW) cხელმოწერის არსებობამდე მუდმივად სკანირებს NPM-ს, PyPI-ს და Maven-ს მავნე პაკეტების აღმოსაჩენად, რითაც ამოწმებს Shai-Hulud-ის, axios-ის და SAP npm-ის უკან მდგომ მიწოდების ჯაჭვის ზუსტ სქემას. AI Security აღმოაჩენს ყველა AI აქტივს მთელს ქსელში. SDLC, აფასებს მას ზემოთ მოცემულ OWASP ჩარჩოებთან შედარებით და Shield არაუსაფრთხო მოდელის, აგენტის ან MCP სერვერის გაშვების ნებართვის მიღებამდე, ბოლო წერტილში აწესებს პოლიტიკას.
2026 წელს ხელოვნური ინტელექტის რისკების კარგად მართვადი ორგანიზაციები არ არიან ისინი, ვინც ყველაზე მეტ ინსტრუმენტს იყენებენ. სწორედ მათ შეუძლიათ ნახონ ყველა ხელოვნური ინტელექტის აქტივი, რომელსაც იყენებენ, შეაჩერონ ის, რაც სახიფათოა, სანამ ის ამოქმედდება და ეს ინფორმაცია უკვე არსებულ ინსტრუმენტებზე გამოიყენონ.

კითხვა-პასუხი
რა არის კიბერუსაფრთხოების ყველაზე დიდი საფრთხეები 2026 წელს?
მიწოდების ჯაჭვზე თავდასხმები მოცულობითა და დანახარჯებით ყველაზე დიდ კატეგორიად რჩება, წელს ზარალი დაახლოებით 60 მილიარდი დოლარია, ხოლო შეტევა დაახლოებით ყოველ 48 საათში ერთხელ ხორციელდება. მათთან ერთად, ხელოვნური ინტელექტის საფრთხეები სწრაფად მზარდ კატეგორიად გამოიკვეთა: ხელოვნური ინტელექტის მიერ მიზნობრივი ავტორიზაციის ქურდობა ერთ კვარტალში 376%-ით გაიზარდა, ხოლო Shai-Hulud-ის, axios-ისა და PromptMink-ის მსგავსი ინციდენტები აჩვენებს, რომ თავდამსხმელები აქტიურად იყენებენ ხელოვნურ ინტელექტს როგორც სამიზნედ, ასევე მიწოდების მექანიზმად.
წარმოადგენს თუ არა ხელოვნური ინტელექტის მიერ გენერირებული კოდი უსაფრთხოების რისკს?
დიახ. კვლევები აჩვენებს, რომ ხელოვნური ინტელექტის მიერ გენერირებული კოდის დაახლოებით 40% შეიცავს უსაფრთხოების ხარვეზებს. ეს დეველოპერის IDE-ში რეალურ დროში ვალიდაციას, კოდის შერწყმამდე, წყაროში ხელოვნური ინტელექტის უსაფრთხოების რისკების შემცირების ერთ-ერთ ყველაზე ეფექტურ გზად აქცევს.
რა არის MEW და როგორ უმკლავდება ის ხელოვნური ინტელექტის საფრთხეებს?
მავნე პროგრამების ადრეული გაფრთხილება (MEW) არის Xygeni-ის უწყვეტი სკანირების სისტემა NPM, PyPI და Maven-ისთვის. ის შექმნილია მავნე პაკეტების აღმოსაჩენად ხელმოწერის არსებობამდე, რაც მნიშვნელოვანია, რადგან რეპუტაციაზე დაფუძნებული ინსტრუმენტები მხოლოდ უკვე იდენტიფიცირებულ პაკეტებს იჭერენ და ვერ ამჩნევენ ხელოვნური ინტელექტის ბოლოდროინდელი საფრთხეებისა და მიწოდების ჯაჭვის ჭიების ზუსტ ნულოვანი დღის ნიმუშს.
წარმოადგენენ თუ არა MCP სერვერები ხელოვნური ინტელექტის რისკების რეალურ წყაროს?
დიახ. საჯარო MCP სერვერები ავლენენ ხელოვნური ინტელექტის უსაფრთხოების გაზომვად რისკებს: მათი 5.5%-ს ხელსაწყოების მოწამვლის ხარვეზები აქვს, ხოლო 43%-ს ბრძანების ინექციის ხარვეზები, ხოლო მხოლოდ ერთი კომპრომეტირებული MCP ხიდი აღმოჩენამდე 437 000-ჯერ იქნა გადმოწერილი.
