






Et gjennomsnittlig AppSec-team håndterer tusenvis av åpne funn til enhver tid. De fleste av dem er ikke verdt å fikse i dag. Noen er ikke verdt å fikse noen gang. Problemet er ikke at sikkerhetsteam mangler innsats; det er at manuell sortering ikke skalerer, og utbedring uten prioritering produserer en etterslep som vokser raskere enn den krymper. AI-triage og AI AutoFix endrer økonomien til utbedring av sårbarheterAI-triage filtrerer støyen og reduserer tusenvis av funn til den håndfullen som virkelig kan utnyttes, nås og er forretningskritiske. AI AutoFix lukker disse funnene automatisk og leverer sikre, kontekstbevisste rettelser direkte inn i utviklerens arbeidsflyt uten behov for manuell oppdatering. Sammen er de det praktiske svaret på problemet med sikkerhetsetterslep som har plaget AppSec-team siden statiske analyseverktøy først begynte å generere flere funn enn noen kunne gjøre noe med.
Denne veiledningen forklarer hvordan AI-triage fungerer, hva AI AutoFix faktisk gjør i praksis, hvordan støyreduksjon og automatisert sårbarhetsutbedring kobles sammen, og hva man skal se etter når man vurderer verktøy.
Problemet med etterslep: Hvorfor manuell utbedring bryter sammen i stor skala
Sikkerhetsetterslep er ikke et disiplinproblem. Det er et matteproblem.
Et moderne applikasjonssikkerhetsprogram som kjører SAST, SCA, avsløring av hemmeligheter, IaC Skanning, og DAST på tvers av en mellomstor ingeniørorganisasjon genererer titusenvis av funn per måned. Hvert funn krever at et menneske leser det, vurderer alvorlighetsgraden i kontekst, avgjør om det kan utnyttes i den spesifikke applikasjonen og miljøet, bestemmer om det er verdt å fikse det nå eller senere, tilordner det til en utvikler, venter på fiksen og bekrefter resultatet. Den prosessen tar tid de fleste sikkerhetsteam ikke har.
Resultatet er et etterslep som forverres. Funn med høy alvorlighetsgrad fra seks måneder siden ligger side om side med funn med middels alvorlighetsgrad fra forrige uke. Utviklere mottar saker uten klar veiledning om utbedring. Sikkerhetsteam bruker tiden sin på triage i stedet for utbedring. Og funnene som faktisk representerer utnyttbar risiko, de som ville ha betydning i et reelt angrep – er begravd i en liste med varsler om lavt signalnivå som ingen har tid til å lese nøye.
Tre dynamikker forverrer etterslepet over tid. For det første har AI-generert kode akselerert volumet av kode som går inn i produksjon, og med det volumet av funn. Veracodes analyse fra 2025 fant at bare 55 % av AI-generert kode var sikker på tvers av over 100 testede modeller. For det andre betyr spredningen av AppSec-verktøy at funn kommer fra flere skannere uten enhetlig oversikt og delt prioriteringslogikk. For det tredje er de fleste statiske analyseverktøyene innstilt for fullstendighet snarere enn forhåndsgodkjente.cision; de vil heller flagge noe trygt enn å overse noe farlig, som genererer falske positiver som svekker utviklernes tillit og forsinker utbedringen ytterligere.
AI-triage og automatisert sårbarhetsutbedring adresserer alle tre dynamikkene direkte.
Hva AI-triage egentlig gjør
AI-triage er anvendelsen av maskinlæring og kontekstuell analyse på problemet med å finne prioriteringer. Målet er ikke å finne flere sårbarheter; det er å identifisere hvilke av sårbarhetene som allerede er funnet som det er verdt å handle på, i hvilken rekkefølge og hvorfor.
Tradisjonell alvorlighetspoengsum (CVSS(for eksempel) tildeler en poengsum basert på sårbarhetens generelle egenskaper: angrepsvektor, kompleksitet, nødvendige rettigheter, påvirkning. Den vet ikke om den sårbare funksjonen faktisk kalles i applikasjonen din, om den er tilgjengelig fra internett, om den ligger bak autentisering, eller om den påvirker et system som håndterer sensitive data. En kritisk CVSS-poengsum på en funksjon som aldri kalles i produksjon er ikke en kritisk risiko; det er støy.
AI-triage anvender konteksten som CVSS ikke kan. Den kombinerer:
- Reachability-analyse: avgjøre om den sårbare kodebanen faktisk kjøres i det kjørende programmet, og ikke bare finnes i kodebasen. En sårbarhet i død kode kan ikke utnyttes. AI-triage vet forskjellen.
- UtnyttbarhetspoengsumBruk av data fra EPSS (Exploit Prediction Scoring System) og telemetri for angrep i den virkelige verden for å vurdere sannsynligheten for at en gitt sårbarhet vil bli utnyttet i praksis. Ikke alle CVE-er med en offentlig utnyttelse brukes aktivt. Ikke alle sårbarheter uten en er trygge.
- Kontekst om påvirkning av næringslivet: forstå hvilke applikasjoner, tjenester og dataressurser som påvirkes av et funn, og vekte alvorlighetsgraden deretter. En SQL-injeksjon i et offentlig API som håndterer betalingsdata er kategorisk forskjellig fra det samme funnet i et internt rapporteringsverktøy uten ekstern tilgang.
- Falsk positiv filtreringidentifisere funn som samsvarer med et kjent sårbart mønster, men som ikke faktisk kan utnyttes i kontekst, og fjerne dem fra den aktive køen før en utvikler i det hele tatt ser dem.
Resultatet av AI-triage er ikke en kortere liste med de samme funnene. Det er en kvalitativt annerledes liste, en der hvert element representerer en reell, prioritert, handlingsrettet risiko snarere enn en teoretisk mulighet. Team som kjører AI-triage ser vanligvis 80–90 % støyreduksjon fra rå skannerutdata til handlingsrettede funn.
Hva AI AutoFix faktisk gjør
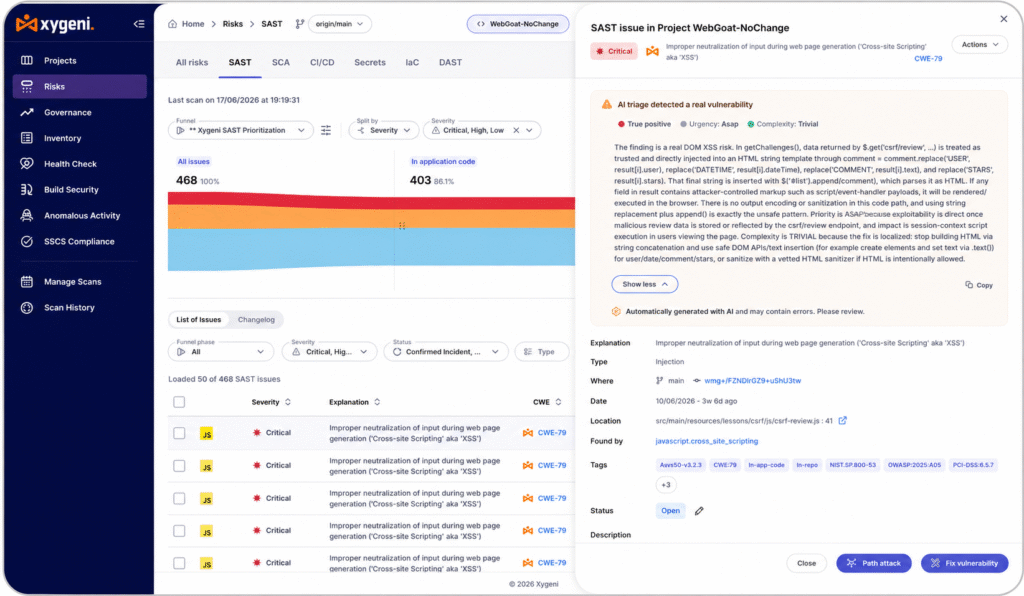
AI AutoFix er utbedringssiden av ligningen. Der AI-sortering identifiserer hva som skal fikses, genererer AI AutoFix selve reparasjonen, en sikker, kontekstbevisst kodeendring som løser sårbarheten uten å introdusere nye problemer.
Forskjellen fra generisk AI-kodegenerering er viktig her. En generell AI-assistent som blir bedt om å fikse et SQL-injeksjonssårbarhet, vil produsere kode som ser rimelig ut. AI AutoFix i en sikkerhetsplattform produserer kode som er validert mot det spesifikke sårbarhetsmønsteret, det spesifikke språket og rammeverket som brukes, de spesifikke kodingskonvensjonene til depotet og den spesifikke risikokonteksten som er identifisert av triagelaget. Rettelsen er ikke et forslag, det er en pull request, klar for utviklergjennomgang, med sårbarheten løst og forklaring av feilrettingen inkludert.
Hva AI AutoFix gjør i praksis:
- Erstatter risikable mønstre med trygge alternativer. En parameterisert spørring i stedet for strengsammenkobling. Et sikkert deserialiseringsbibliotek i stedet for et sårbart. En funksjon for validering av inndata i stedet for direkte brukerinput i et systemkall. Rettelsen adresserer rotårsaken, ikke bare symptomet.
- Håndterer brudd i endringsbevissthet. Det er enkelt å oppdatere en sårbar avhengighet når den nye versjonen er en midlertidig erstatning. Det blir komplekst når API-et har endret seg, når transitive avhengigheter kommer i konflikt, eller når fiksen ødelegger eksisterende tester. AI AutoFix forstår avhengighetsgrafen og flagger eller håndterer endringer som ødelegger før pull request er åpnet.
- Leverer feilrettinger der utviklere jobber. De mest effektive AutoFix-implementeringene viser rettelser i IDE-en etter hvert som koden skrives, i CI/CD pipeline slik koden er committed, og i pull requests ettersom koden gjennomgås, ikke i en separat sikkerhetsenhet dashboard som utviklere aldri åpner. Friksjon er fienden til utbedringshastighet.
- Vekter uten antall ansatte. Et sikkerhetsteam på fem personer kan ikke manuelt gjennomgå og rette opp fem tusen funn. AI AutoFix kan generere og sende inn rettelser for alle fem tusen, slik at sikkerhetsteamet må gjennomgå og godkjenne i stedet for å redigere hver endring.
Støyreduksjon i praksis: Fra tusenvis av funn til de som betyr noe
Støyreduksjon er ikke bare en forbedring av livskvaliteten. Det er et sikkerhetsresultat. Når utviklere mottar tusenvis av varsler, utvikler de varslingsutmattelse, det veldokumenterte fenomenet der store mengder varsler om lavt signal fører til at mennesker slutter å lese dem nøye. Varslingsutmattelse forsinker ikke bare utbedring. Det fører til at reelle sårbarheter blir oversett.
Støyreduksjonen pipeline som AI-triage muliggjør ser slik ut i praksis:
A SAST Skanneren kjører på tvers av et datalager og produserer 2,400 funn. Uten sortering havner alle 2,400 i en etterslep. Med AI-sortering filtreres funnene etter tilgjengelighet (fjerning av funn i utilgjengelige kodebaner), etter utnyttbarhet (fjerning av funn uten realistisk angrepsvektor i gjeldende kontekst), etter falsk positiv sannsynlighet (fjerning av funn som samsvarer med et mønster, men som er påviselig trygge i kontekst) og etter forretningspåvirkning (rangering av de gjenværende funnene etter alvorlighetsgraden av dataene og systemene de påvirker). Resultatet er 60 prioriterte funn, de som representerer reell, handlingsrettet risiko i den spesifikke applikasjonen og miljøet.
Disse 60 funnene går til utviklere med veiledning for utbedringer. AI AutoFix genererer pull requests for de med klare, trygge automatiserte rettelser. Sikkerhetsteamet gjennomgår og godkjenner. De 60 reelle risikoene er løst. De 2,340 ikke-problemene nådde aldri en utviklers kø.
Det er ikke en marginal effektivitetsforbedring. Det er forskjellen mellom et sikkerhetsprogram som skalerer og et som ikke gjør det.
Verktøykonsolidering: En bivirkning verdt å planlegge for
En av de mindre omtalte fordelene med AI-triage og AI AutoFix er hva de gjør for å verktøye for spredning.
De fleste AppSec-team kjører flere skannere: én for SAST, en for SCA, en for hemmeligheter, en for IaC, én for containere, én for DAST. Hver skanner produserer sitt eget funnformat, sin egen alvorlighetsskala, sin egen falske positive rate og sin egen utbedringsveiledning, eller ingen utbedringsveiledning i det hele tatt. Sikkerhetsteam bruker mye tid på å avstemme funn på tvers av verktøy, deduplisere varsler som representerer det samme underliggende problemet, og oversette skannerutdata til utviklerlesbare billetter.
En plattform som kombinerer AI-sortering på tvers av alle søkekilder med enhetlig AutoFix-levering eliminerer mesteparten av denne overheaden. Funn fra SAST, SCA, hemmeligheter og IaC flyt inn i én enkelt prioriteringsmotor. Triagelaget bruker konsistent poengsumlogikk på tvers av alle kilder. AutoFix genererer rettelser uavhengig av hvilken skanner som identifiserte problemet. Utvikleren ser én kø, én alvorlighetsskala, ett rettelsesformat.
Sikkerhetsteamet administrerer én plattform i stedet for fem. Leverandørkontrakter konsolideres. Integrasjonsvedlikehold reduseres. Og den enhetlige datamodellen betyr at triagelaget har mer kontekst, et funn som vises i begge. SAST og SCA utdata, og er også tilgjengelig fra et offentlig eksponert endepunkt, får høyere poengsum enn noen av skannerne ville gitt den alene.
Verktøykonsolidering er ikke hovedmålet med AI-triage og AutoFix; reduksjon av etterslep er det. Men det er en konsekvens som forverres over tid, reduserer driftskostnader og forbedrer kvaliteten på prioriteringssignalet.
Slik evaluerer du AI-triage og AutoFix-verktøy
Ikke alle implementeringer av AI-triage og AutoFix gir samme resultat. Dette er funksjonene som skiller ekte støyreduksjon og automatisert sårbarhetsutbedring fra en markedsføringspåstand:
- Prioritering basert på tilgjengelighet, ikke bare alvorlighetsgrad. Hvis verktøyet scorer funnene utelukkende på CVSS uten å forstå om den sårbare kodebanen faktisk kjøres, utfører det ikke AI-triage; det utfører sortering. Spør leverandørene spesifikt hvordan tilgjengelighet bestemmes og hvilke datakilder som informerer utnyttbarhetsscoring.
- Kryssskannerkorrelasjon. Et triagelag som bare ser funn fra én skanner har et ufullstendig bilde. Den mest nøyaktige prioriteringen kommer fra å korrelere funn på tvers av SAST, SCA, hemmeligheter, IaC, og DAST, forstå når flere verktøy markerer den samme underliggende risikoen, og vekte det signalet på riktig måte.
- AutoFix-kvalitet og validering. En rettelse som introduserer en ny sårbarhet eller ødelegger eksisterende funksjonalitet er verre enn ingen rettelse. Evaluer rettelseskvaliteten ved å spørre om AutoFix er validert mot kjente sikre mønstre, om den håndterer endringer som ødelegger, og om den inkluderer testdekning for den utbedrede kodebanen.
- IDE og pipeline integrering. AutoFix som dukker opp i en separat dashboard krever at utviklere forlater arbeidsflyten sin for å kunne handle på den. Den raskeste utbedringen skjer når rettelser er tilgjengelige i IDE-en, i PR-en og i CI/CD pipeline, uansett hvor utvikleren allerede jobber.
- Falsk positiv rate, ikke bare sann positiv rate. Den sanne positive raten forteller deg hvor mye verktøyet fanger opp. Den falske positive raten forteller deg hvor mye støy det genererer. Begge deler er viktig, og forholdet mellom dem er det virkelige signalet. Be om referansedata, ikke bare markedsføringspåstander.
- Revisjonsspor og overstyringsfunksjon. AutoFix i en produksjon pipeline trenger styring. Utviklere og sikkerhetsteam må kunne gjennomgå, godkjenne, endre og avvise automatiserte rettelser, med et fullstendig revisjonsspor over hva som ble endret, hvorfor og av hvem.
AI-triage og autofix med Xygeni
Xygenis Tilnærmingen til automatisert sårbarhetsutbedring er bygget rundt ett prinsipp: deteksjon uten utbedring er et etterslep som venter på å skje.
Ocuco Xygeni-prioriteringstrakt anvender AI-sortering på tvers av alle funnkilder (SAST, SCA, avsløring av hemmeligheter, IaC, CI/CD sikkerhet og DAST), og reduserer rå skannerutdata gjennom suksessive lag med tilgjengelighetsanalyse, utnyttbarhetsscoring og forretningskontekst. Utdataene er en prioritert kø av genuint handlingsrettede funn, ikke en flat liste over alt skanneren fant.
AI AutoFix genererer kontekstbevisste, språkspesifikke rettelser levert direkte til pull requests, dekker SAST funn, sårbare avhengigheter og eksponering av hemmeligheter på tvers av menneskeskrevet og AI-generert kode. Brudd på endringer markerer avhengighetsoppdateringer som ville ødelagt bygget før PR-en åpnes. Forklaringer på feilrettinger gir utviklere konteksten til å gjennomgå og godkjenne endringer med tillit i stedet for blind tillit.
DevAI, Xygenis IDE-innebygde AI-sikkerhetskopilot, viser triageresultater og AutoFix-forslag direkte i utviklermiljøet, etter hvert som koden skrives, før en commit er laget. MCP-serverintegrasjonen betyr at AI-kodingsassistenter kan utløse sikkerhetsskanninger, motta prioriterte funn og bruke sikre rettelser uten å forlate IDE-en.
Resultatet: Team som kjører Xygeni rapporterer at de har gått fra tusenvis av åpne funn til en håndterbar, prioritert kø, og fra manuell oppdatering til automatisert utbedring som skalerer med kodebasen i stedet for med antall ansatte. Hvis sikkerhetsetterslepet ditt vokser raskere enn teamet ditt kan håndtere det, er ikke problemet innsatsen. Det er at verktøyene du bruker ikke ble bygget for å løse det.

FAQ
Hvor mye kan AI-triage redusere støy fra sikkerhetsetterslep?
Team som bruker AI-triage med tilgjengelighetsbasert prioritering ser vanligvis en reduksjon på 80–90 % fra rå skannerutdata til handlingsrettede funn. Det nøyaktige tallet avhenger av kodebasen, antall skannere i bruk og spesifisiteten til triagemodellen, men den retningsbestemte effekten er konsistent: de fleste funn produsert av statiske analyseverktøy kan ikke utnyttes i kontekst, og AI-triage identifiserer og fjerner dem før de når utviklerkøen.
Er AI AutoFix trygt å bruke i produksjon pipelines?
Ja, når det implementeres med riktig styring. AI AutoFix bør alltid inkludere menneskelig gjennomgang før endringer slås sammen til produksjon; verdien ligger i å generere rettelsen automatisk, ikke i å omgå gjennomgangsprosessen. Se etter implementeringer som inkluderer forklaringer på rettelser, deteksjon av avbrytende endringer og et fullstendig revisjonsspor for hva som ble endret og hvorfor.
Hvordan er automatisert sårbarhetsutbedring forskjellig fra manuell oppdatering?
Manuell oppdatering krever at en sikkerhetsingeniør eller utvikler leser funnet, forstår sårbarheten, undersøker den sikre løsningen, implementerer den, tester den og sender den inn for gjennomgang. Automatisert sårbarhetsutbedring genererer løsningen automatisk basert på sårbarhetstypen, språket, rammeverket og kodekonvensjonene, noe som reduserer tiden fra funn til reparasjon fra dager eller uker til timer eller minutter, og skalerer over hele funnkøen i stedet for ett problem om gangen.
Hva er sammenhengen mellom støyreduksjon og reduksjon av sikkerhetsetterslep?
Det er to sider av samme problem. Støy (lavt signal, ikke-utnyttbare funn eller falskt positive funn) fyller etterslepet med elementer som aldri burde ha nådd en utviklers kø. Støyreduksjon gjennom AI-sortering fjerner disse elementene oppstrøms, slik at etterslepet bare inneholder reelle risikoer. AutoFix lukker deretter disse reelle risikoene raskere. Kombinasjonen krymper etterslepet fra begge ender samtidig.
