






AppSec-ის საშუალო გუნდი ნებისმიერ დროს ათასობით ღია აღმოჩენას მართავს. მათი უმეტესობა დღეს გამოსწორების ღირსი არ არის. ზოგიერთის გამოსწორება კი არასდროს ღირს. პრობლემა ის არ არის, რომ უსაფრთხოების გუნდებს ძალისხმევა არ აკლიათ; პრობლემა ის არის, რომ ხელით დახარისხება არ მასშტაბირდება და პრიორიტეტების დადგენის გარეშე გამოსწორება წარმოქმნის დაგროვილ საქმეებს, რომლებიც უფრო სწრაფად იზრდება, ვიდრე მცირდება. ხელოვნური ინტელექტის კლასიფიკაცია და ხელოვნური ინტელექტის ავტომატური ფიქსი ცვლის ეკონომიკის საკითხებს. დაუცველობის აღმოფხვრახელოვნური ინტელექტის კლასიფიკაცია ფილტრავს ხმაურს, ათასობით აღმოჩენას ამცირებს მხოლოდ იმ მცირერიცხოვან მონაცემდე, რომლებიც ნამდვილად გამოსაყენებელია, ხელმისაწვდომია და ბიზნესისთვის კრიტიკულია. ხელოვნური ინტელექტის ავტომატური შეკეთება ავტომატურად ხურავს ამ აღმოჩენებს და უსაფრთხო, კონტექსტიდან გამომდინარე შესწორებებს პირდაპირ დეველოპერის სამუშაო პროცესში, ხელით შესწორების გარეშე აწვდის. ერთად, ისინი წარმოადგენენ პრაქტიკულ პასუხს უსაფრთხოების დაგროვილი პრობლემებისთვის, რომელიც AppSec-ის გუნდებს აწუხებთ მას შემდეგ, რაც სტატიკური ანალიზის ინსტრუმენტებმა პირველად დაიწყეს იმაზე მეტი აღმოჩენის გენერირება, ვიდრე ვინმეს შეეძლო მოქმედება.
ეს სახელმძღვანელო განმარტავს, თუ როგორ მუშაობს ხელოვნური ინტელექტის კლასიფიკაცია, რას აკეთებს სინამდვილეში AI AutoFix პრაქტიკაში. როგორ უკავშირდება ხმაურის შემცირება და ავტომატური დაუცველობის აღმოფხვრადა რას უნდა მივაქციოთ ყურადღება ხელსაწყოების შეფასებისას.
დაგროვილი მასალების პრობლემა: რატომ ხდება ხელით შეკეთება მასშტაბურად
უსაფრთხოების საკითხების შეფერხებები დისციპლინის პრობლემა არ არის. ისინი მათემატიკური პრობლემაა.
თანამედროვე აპლიკაციის უსაფრთხოების პროგრამა მუშაობს SAST, SCA, საიდუმლოებების აღმოჩენა, IaC სკანირება და DAST საშუალო ზომის საინჟინრო ორგანიზაციაში თვეში ათიათასობით აღმოჩენას წარმოქმნის. თითოეული აღმოჩენა ადამიანის მიერ უნდა წაიკითხოს, შეაფასოს მისი სიმძიმე კონტექსტში, დაადგინოს, არის თუ არა ის ექსპლუატაციაში გამოსაყენებელი კონკრეტულ აპლიკაციასა და გარემოში, გადაწყვიტოს, ღირს თუ არა მისი გამოსწორება ახლავე თუ მოგვიანებით, დაავალოს დეველოპერს, დაელოდოს გამოსწორებას და გადაამოწმოს შედეგი. ამ პროცესს დრო სჭირდება, რაც უსაფრთხოების ჯგუფების უმეტესობას არ აქვს.
შედეგად, საქმეების დაგროვება იზრდება. ექვსი თვის წინანდელი მაღალი სიმძიმის დასკვნები გასულ კვირას გამოვლენილ საშუალო სიმძიმის დასკვნებთან ერთად დევს. დეველოპერები იღებენ ჯარიმებს გამოსწორების მკაფიო ინსტრუქციის გარეშე. უსაფრთხოების ჯგუფები დროს ტრიაჟში ხარჯავენ და არა გამოსწორებაში. დასკვნები, რომლებიც რეალურად წარმოადგენს ექსპლუატაციად რისკს, რომლებიც მნიშვნელოვანი იქნებოდა რეალური შეტევის დროს, დამარხულია დაბალი სიგნალის გაფრთხილებების სიაში, რომლის ყურადღებით წაკითხვის დრო არავის აქვს.
სამი დინამიკა დროთა განმავლობაში აუარესებს შეკავებულ საქმეებს. პირველი, ხელოვნური ინტელექტის მიერ გენერირებულმა კოდმა დააჩქარა წარმოებაში შესული კოდის მოცულობა და მასთან ერთად, აღმოჩენების მოცულობაც. Veracode-ის 2025 წლის ანალიზმა აჩვენა, რომ მხოლოდ ხელოვნური ინტელექტის მიერ გენერირებული კოდის 55% უსაფრთხო იყო 100-ზე მეტ გამოცდილ მოდელში. მეორეც, AppSec ინსტრუმენტების გავრცელება ნიშნავს, რომ დასკვნები მრავალი სკანერიდან მოდის ერთიანი ხედვისა და პრიორიტეტების საერთო ლოგიკის გარეშე. მესამე, სტატიკური ანალიზის ინსტრუმენტების უმეტესობა სისრულეზეა მორგებული და არა წინასწარ.cisისინი ამჯობინებენ უსაფრთხო რამის მონიშვნას, ვიდრე საშიში რამის გამოტოვებას, რაც ცრუ დადებით შედეგებს წარმოქმნის რაც დეველოპერების ნდობას ძირს უთხრის და გამოსწორებას კიდევ უფრო ანელებს.
ხელოვნური ინტელექტის კლასიფიკაცია და ავტომატიზირებული დაუცველობის გამოსწორება პირდაპირ სამივე დინამიკას ეხება.
რას აკეთებს სინამდვილეში ხელოვნური ინტელექტის ტრიაჟი
ხელოვნური ინტელექტის კლასიფიკაცია გულისხმობს მანქანური სწავლებისა და კონტექსტუალური ანალიზის გამოყენებას პრიორიტეტულობის პრობლემის მოსაგვარებლად. მისი მიზანი არ არის მეტი დაუცველობის პოვნა; მისი მიზანია იმის დადგენა, თუ უკვე აღმოჩენილი დაუცველობებიდან რომელი ღირს მოქმედება, რა თანმიმდევრობით და რატომ.
ტრადიციული სიმძიმის შეფასება (CVSSმაგალითად) ანიჭებს ქულას დაუცველობის ზოგადი მახასიათებლების მიხედვით: შეტევის ვექტორი, სირთულე, საჭირო პრივილეგიები, გავლენა. მან არ იცის, რეალურად გამოიძახეს თუ არა დაუცველი ფუნქცია თქვენს აპლიკაციაში, ხელმისაწვდომია თუ არა ის ინტერნეტიდან, დგას თუ არა ის ავტორიზაციის მიღმა, თუ გავლენას ახდენს თუ არა სისტემაზე, რომელიც ამუშავებს მგრძნობიარე მონაცემებს. კრიტიკული CVSS ქულა ფუნქციაზე, რომელიც არასდროს გამოიძახება წარმოებაში, არ წარმოადგენს კრიტიკულ რისკს; ეს არის ხმაური.
ხელოვნური ინტელექტის ტრიაჟი იყენებს კონტექსტს, რასაც CVSS ვერ აკეთებს. ის აერთიანებს:
- ხელმისაწვდომობის ანალიზი: იმის დადგენა, რეალურად სრულდება თუ არა დაუცველი კოდის გზა გაშვებულ აპლიკაციაში და არა მხოლოდ კოდის ბაზაშია წარმოდგენილი. მოძველებულ კოდში არსებული დაუცველობა ექსპლუატაციადი არ არის. ხელოვნური ინტელექტის ტრიაჟმა იცის განსხვავება.
- ექსპლუატაციის შეფასებაEPSS-ის (ექსპლუატაციის პროგნოზირების შეფასების სისტემა) და რეალური სამყაროს შეტევის ტელემეტრიის მონაცემების გამოყენებით, შეფასდება იმის ალბათობა, რომ მოცემული დაუცველობა ექსპლუატაციის სახით იქნება გამოყენებული. ყველა CVE საჯარო ექსპლოიტის შემცველი აქტიურად არ გამოიყენება. ყველა დაუცველობა, რომელსაც ეს დაუცველობა არ გააჩნია, უსაფრთხო არ არის.
- ბიზნესზე გავლენის კონტექსტი: იმის გაგება, თუ რომელ აპლიკაციებზე, სერვისებსა და მონაცემთა აქტივებზე ახდენს გავლენას დასკვნა და შესაბამისად, სიმძიმის შეფასება. SQL ინექცია საჯარო API-ში, რომელიც ამუშავებს გადახდის მონაცემებს, კატეგორიულად განსხვავდება იგივე დასკვნისგან შიდა ანგარიშგების ინსტრუმენტში, რომელსაც არ აქვს გარე წვდომა.
- ცრუ დადებითი ფილტრაცია: ისეთი აღმოჩენების იდენტიფიცირება, რომლებიც შეესაბამება ცნობილ დაუცველ ნიმუშს, მაგრამ კონტექსტში რეალურად არ არის ექსპლუატაციაში გამოსაყენებელი და მათი აქტიური რიგიდან ამოღება მანამ, სანამ დეველოპერი მათ ნახავს.
ხელოვნური ინტელექტის ტრიაჟის შედეგი არ არის ერთი და იგივე დასკვნების მოკლე სია. ეს არის თვისობრივად განსხვავებული სია, სადაც თითოეული პუნქტი წარმოადგენს რეალურ, პრიორიტეტულ, ქმედით რისკს და არა თეორიულ შესაძლებლობას. ხელოვნური ინტელექტის ტრიაჟის განმახორციელებელი გუნდები, როგორც წესი, ხედავენ ხმაურის 80-90%-ით შემცირებას სკანერის ნედლი გამომავალიდან ქმედით დასკვნებამდე.
რას აკეთებს სინამდვილეში ხელოვნური ინტელექტის ავტომატური შეკეთება
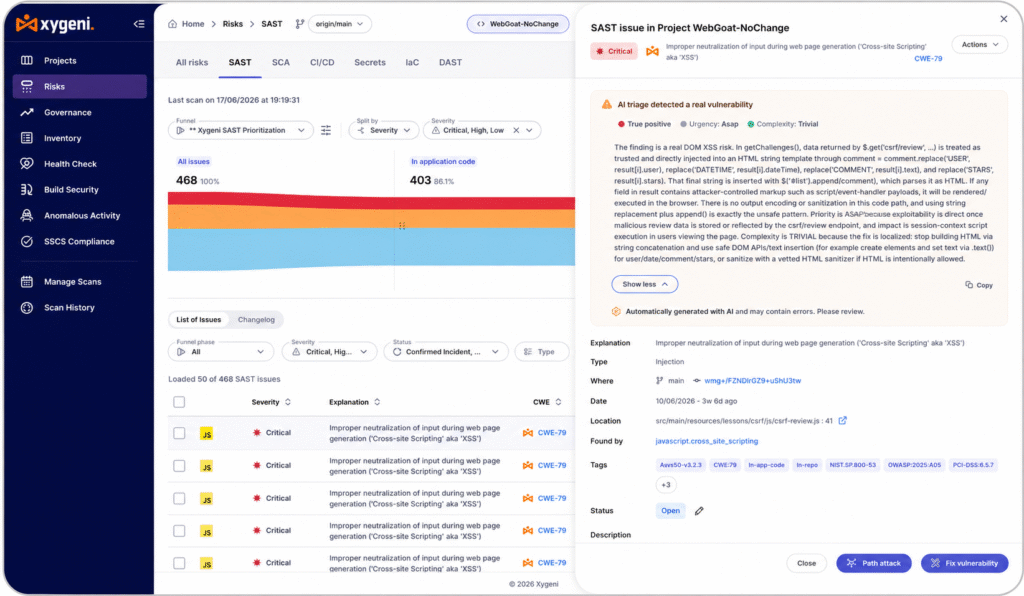
ხელოვნური ინტელექტის ავტოფიქსი განტოლების გამოსწორების მხარეს წარმოადგენს. თუ ხელოვნური ინტელექტის ტრიაჟი განსაზღვრავს, თუ რა უნდა გამოსწორდეს, AI ავტოფიქსი თავად წარმოქმნის გამოსწორებას, უსაფრთხო, კონტექსტიდან გამომდინარე კოდის ცვლილებას, რომელიც აგვარებს დაუცველობას ახალი პრობლემების წარმოშობის გარეშე.
აქ მნიშვნელოვანია განსხვავება ზოგადი ხელოვნური ინტელექტის კოდის გენერირებისგან. ზოგადი დანიშნულების ხელოვნური ინტელექტის ასისტენტი, რომელსაც SQL ინექციის დაუცველობის გამოსწორება სთხოვეს, შექმნის კოდს, რომელიც გონივრულად გამოიყურება. უსაფრთხოების პლატფორმაზე ხელოვნური ინტელექტის ავტომატური შეკეთება ქმნის კოდს, რომელიც დამოწმებულია კონკრეტული დაუცველობის ნიმუშის, გამოყენებული კონკრეტული ენისა და ჩარჩოს, საცავის კონკრეტული კოდირების კონვენციების და ტრიაჟის ფენის მიერ იდენტიფიცირებული კონკრეტული რისკის კონტექსტის მიხედვით. გამოსწორება არ არის წინადადება, ეს არის pull request, მზადაა დეველოპერების განსახილველად, მოგვარებული დაუცველობით და გამოსწორების ახსნა-განმარტებით.
რას აკეთებს AI AutoFix პრაქტიკაში:
- სარისკო ნიმუშებს უსაფრთხო ალტერნატივებით ცვლის. პარამეტრიზებული მოთხოვნა სტრიქონების კონკატენაციის ნაცვლად. უსაფრთხო დესერიალიზაციის ბიბლიოთეკა დაუცველი ბიბლიოთეკის ნაცვლად. შეყვანის ვალიდაციის ფუნქცია სისტემურ ზარში მომხმარებლის პირდაპირი შეყვანის ნაცვლად. გამოსწორება ეხება ძირეულ მიზეზს და არა მხოლოდ სიმპტომს.
- უმკლავდება ცვლილებების შესახებ ცნობიერების დარღვევას. დაუცველი დამოკიდებულების განახლება მარტივია, როდესაც ახალი ვერსია წარმოადგენს ჩანაცვლებას. ეს რთულდება, როდესაც API იცვლება, როდესაც გარდამავალი დამოკიდებულებები კონფლიქტშია ან როდესაც გამოსწორება არღვევს არსებულ ტესტებს. AI AutoFix ესმის დამოკიდებულების გრაფიკს და აფიქსირებს ან ამუშავებს რღვევის ცვლილებებს მანამ, სანამ... pull request იხსნება
- გთავაზობთ შესწორებებს იქ, სადაც დეველოპერები მუშაობენ. AutoFix-ის ყველაზე ეფექტური იმპლემენტაციები IDE-ში კოდის დაწერის დროს ზედაპირულ შესწორებებს წარმოადგენს. CI/CD pipeline როგორც კოდია commitტედი და შიგნით pull requests რადგან კოდი განიხილება და არა ცალკეულ ფასიან ქაღალდში dashboard რომელსაც დეველოპერები არასდროს ხსნიან. ხახუნი გამოსწორების სიჩქარის მტერია.
- სასწორები დასაქმებულთა რაოდენობის გარეშე. ხუთკაციანი უსაფრთხოების გუნდს არ შეუძლია ხუთი ათასი აღმოჩენის ხელით გადახედვა და გამოსწორება. AI AutoFix-ს შეუძლია ხუთი ათასივე აღმოჩენის გამოსწორების გენერირება და წარდგენა, რაც უსაფრთხოების გუნდს აძლევს ყველა ცვლილების გადახედვისა და დამტკიცების უფლებას, ავტორის ნაცვლად.
ხმაურის შემცირება პრაქტიკაში: ათასობით აღმოჩენიდან მნიშვნელოვან აღმოჩენებამდე
ხმაურის შემცირება მხოლოდ ცხოვრების ხარისხის გაუმჯობესება არ არის. ეს უსაფრთხოების შედეგია. როდესაც დეველოპერები ათასობით შეტყობინებას იღებენ, მათ უვითარდებათ შეტყობინებების დაღლილობა, კარგად დოკუმენტირებული ფენომენი, როდესაც დაბალი სიგნალის მქონე შეტყობინებების დიდი რაოდენობა აიძულებს ადამიანებს შეწყვიტონ მათი ყურადღებით წაკითხვა. შეტყობინებების დაღლილობა არა მხოლოდ ანელებს გამოსწორებას. ის იწვევს რეალური დაუცველობების გამოტოვებას.
ხმაურის შემცირება pipeline რასაც ხელოვნური ინტელექტის ტრიაჟი უზრუნველყოფს, პრაქტიკაში ასე გამოიყურება:
A SAST სკანერი მუშაობს საცავში და წარმოქმნის 2,400 აღმოჩენას. ტრიაჟის გარეშე, ყველა 2,400 აღმოჩენა დაგროვდა. ხელოვნური ინტელექტის ტრიაჟის გამოყენებით, აღმოჩენები იფილტრება ხელმისაწვდომობის (მიუწვდომელი კოდის ბილიკებზე აღმოჩენების მოცილება), ექსპლუატაციის (მიმდინარე კონტექსტში რეალისტური შეტევის ვექტორის არმქონე აღმოჩენების მოცილება), ცრუ დადებითი ალბათობის (ნიმუშს შესაბამისი, მაგრამ კონტექსტში დემონსტრაციულად უსაფრთხო აღმოჩენების მოცილება) და ბიზნესზე ზემოქმედების (დანარჩენი აღმოჩენების რანჟირება მათზე მოქმედი მონაცემებისა და სისტემების სიმძიმის მიხედვით) მიხედვით. შედეგი არის 60 პრიორიტეტული აღმოჩენა, რომლებიც წარმოადგენს რეალურ, ქმედით რისკს კონკრეტულ აპლიკაციასა და გარემოში.
ეს 60 დასკვნა დეველოპერებს გადაეცემათ გამოსწორების რჩევებით. ხელოვნური ინტელექტის ავტომატური შეკეთება (AI AutoFix) წარმოქმნის pull requests მათთვის, ვისაც აქვს მკაფიო, უსაფრთხო ავტომატიზირებული გამოსწორებები. უსაფრთხოების გუნდი განიხილავს და ამტკიცებს. 60 რეალური რისკი მოგვარებულია. 2,340 არაპრობლემა დეველოპერის რიგში არასდროს მიუღწევია.
ეს არ არის ეფექტურობის უმნიშვნელო გაუმჯობესება. ეს განსხვავებაა მასშტაბირებად და არამასშტაბირებად უსაფრთხოების პროგრამას შორის.
ხელსაწყოების კონსოლიდაცია: გვერდითი ეფექტი, რომლის დაგეგმვაც ღირს
ხელოვნური ინტელექტის ტრიაჟისა და AI AutoFix-ის ერთ-ერთი ნაკლებად განხილული უპირატესობა ინსტრუმენტების გაფანტვისას მათი გამოყენების შესაძლებლობაა.
AppSec-ის გუნდების უმეტესობა რამდენიმე სკანერს იყენებს: ერთი SAST, ერთი იმისთვის SCA, ერთი საიდუმლოებისთვის, ერთი IaC, ერთი კონტეინერებისთვის, მეორე DAST-ისთვის. თითოეული სკანერი ქმნის საკუთარ დასკვნების ფორმატს, საკუთარ სიმძიმის შკალას, საკუთარ ცრუ დადებითი შედეგების მაჩვენებელს და საკუთარ გამოსწორების ინსტრუქციას, ან საერთოდ არ იძლევა გამოსწორების ინსტრუქციას. უსაფრთხოების ჯგუფები მნიშვნელოვან დროს ხარჯავენ სხვადასხვა ხელსაწყოს მიერ დასკვნების შეჯერებაზე, იმავე ძირითადი პრობლემის წარმომადგენელი გაფრთხილებების დედუქცირებაზე და სკანერის გამომავალი მონაცემების დეველოპერისთვის წასაკითხ ბილეთებად გარდაქმნაზე.
პლატფორმა, რომელიც აერთიანებს ხელოვნური ინტელექტის კლასიფიკაციას ყველა საძიებო წყაროსთვის ერთიან AutoFix მიწოდებასთან, გამორიცხავს ამ ზედმეტი ხარჯების უმეტესობას. SAST, SCA, საიდუმლოებები და IaC ერთიან პრიორიტეტიზაციის სისტემაში გადავა. დახარისხების ფენა ყველა წყაროზე თანმიმდევრულ შეფასების ლოგიკას იყენებს. AutoFix წარმოქმნის გამოსწორებებს იმის მიუხედავად, თუ რომელმა სკანერმა აღმოაჩინა პრობლემა. დეველოპერი ხედავს ერთ რიგს, ერთ სიმძიმის შკალას, ერთ გამოსწორების ფორმატს.
უსაფრთხოების გუნდი ხუთის ნაცვლად ერთ პლატფორმას მართავს. მომწოდებლების კონტრაქტები კონსოლიდირებულია. ინტეგრაციის მოვლა-პატრონობა მცირდება. ერთიანი მონაცემთა მოდელი კი ნიშნავს, რომ ტრიაჟის ფენას მეტი კონტექსტი აქვს, რაც ორივე შემთხვევაში ვლინდება. SAST მდე SCA გამომავალი და ასევე ხელმისაწვდომი საჯაროდ გამოჩენილი ბოლო წერტილიდან, უფრო მაღალ შეფასებას იღებს, ვიდრე ნებისმიერი სკანერი შეაფასებდა მას ცალ-ცალკე.
ხელოვნური ინტელექტის დახარისხებისა და AutoFix-ის მთავარი მიზანი ინსტრუმენტების კონსოლიდაცია არ არის; შეფერხებების შემცირებაა მთავარი მიზანი. თუმცა, ეს არის შედეგი, რომელიც დროთა განმავლობაში ძლიერდება, რაც ამცირებს ოპერაციულ ხარჯებს და აუმჯობესებს პრიორიტეტების დადგენის სიგნალის ხარისხს.
როგორ შევაფასოთ ხელოვნური ინტელექტის ტრიაჟი და ავტომატური ფიქსის ინსტრუმენტები
ხელოვნური ინტელექტის ტრიაჟისა და AutoFix-ის ყველა იმპლემენტაცია ერთსა და იმავე შედეგს არ იძლევა. ეს არის შესაძლებლობები, რომლებიც განასხვავებს ხმაურის რეალურ შემცირებას და ავტომატიზირებულ დაუცველობის გამოსწორებას მარკეტინგული პრეტენზიისგან:
- ხელმისაწვდომობაზე დაფუძნებული პრიორიტეტიზაცია და არა მხოლოდ სიმძიმის შეფასება. თუ ინსტრუმენტი შედეგებს მხოლოდ CVSS-ზე აფასებს, იმის გაგების გარეშე, რეალურად შესრულებულია თუ არა დაუცველი კოდის გზა, ის არ ახორციელებს ხელოვნური ინტელექტის ტრიაჟს; ის ახორციელებს დახარისხებას. ჰკითხეთ გამყიდველებს კონკრეტულად, თუ როგორ განისაზღვრება ხელმისაწვდომობა და რომელი მონაცემთა წყაროები განსაზღვრავს ექსპლუატაციის ეფექტურობის შეფასებას.
- სკანერის ჯვარედინი კორელაცია. ტრიაჟის ფენას, რომელიც მხოლოდ ერთი სკანერის მონაცემებს ხედავს, არასრული სურათი აქვს. ყველაზე ზუსტი პრიორიტეტიზაცია ხდება სხვადასხვა სკანერის მონაცემების კორელაციით. SAST, SCA, საიდუმლოებები, IaCდა DAST, იმის გაგება, თუ როდის აღნიშნავს მრავალი ინსტრუმენტი ერთსა და იმავე ძირითად რისკს და ამ სიგნალის სათანადოდ შეწონვა.
- AutoFix-ის ხარისხი და ვალიდაცია. გამოსწორება, რომელიც ახალ დაუცველობას შემოიტანს ან არსებულ ფუნქციონალურობას არღვევს, უარესია, ვიდრე გამოსწორების არარსებობა. შეაფასეთ გამოსწორების ხარისხი იმის კითხვით, არის თუ არა AutoFix დადასტურებული ცნობილი უსაფრთხო შაბლონების მიმართ, ამუშავებს თუ არა ის შეცდომით გამოწვეულ ცვლილებებს და მოიცავს თუ არა ის გამოსწორებული კოდის გზის ტესტირების დაფარვას.
- IDE და pipeline ინტეგრაცია. ავტომატური შეკეთება, რომელიც ცალკეულ ადგილას ჩნდება dashboard დეველოპერებს ავალდებულებს, რომ სამუშაო პროცესი დატოვონ და მასზე იმოქმედონ. ყველაზე სწრაფი გამოსწორება ხდება მაშინ, როდესაც შესწორებები ხელმისაწვდომია IDE-ში, PR-ში და CI/CD pipeline, სადაც დეველოპერი უკვე მუშაობს.
- ცრუ დადებითი შედეგების მაჩვენებელი და არა მხოლოდ ჭეშმარიტი დადებითი შედეგების მაჩვენებელი. ჭეშმარიტად დადებითი მაჩვენებელი გიჩვენებთ, თუ რამდენ ხმას იჭერს ინსტრუმენტი. ცრუ დადებითი მაჩვენებელი კი გიჩვენებთ, რამდენ ხმაურს წარმოქმნის ის. ორივე მნიშვნელოვანია და მათ შორის თანაფარდობა რეალურ სიგნალს წარმოადგენს. მოითხოვეთ საორიენტაციო მონაცემები და არა მხოლოდ მარკეტინგული განცხადებები.
- აუდიტის კვალის და გადაფარვის შესაძლებლობა. ავტომატური შეკეთება წარმოებაში pipeline საჭიროებს მმართველობას. დეველოპერებსა და უსაფრთხოების გუნდებს უნდა შეეძლოთ ავტომატიზირებული შესწორებების განხილვა, დამტკიცება, შეცვლა და უარყოფა, სრული აუდიტის კვალით, თუ რა შეიცვალა, რატომ და ვის მიერ.
ხელოვნური ინტელექტის ტრიაჟი და ავტომატური ფიქსაცია Xygeni-ის გამოყენებით
ქსიგენი ავტომატიზირებული დაუცველობის გამოსწორების მიდგომა ერთ პრინციპზეა აგებული: გამოვლენა გამოსწორების გარეშე დაგროვილი დაგროვებაა, რომელიც მოლოდინშია.
ის Xygeni-ის პრიორიტეტიზაციის ძაბრი იყენებს ხელოვნური ინტელექტის ტრიაჟს ყველა საძიებო წყაროზე (SAST, SCA, საიდუმლოებების აღმოჩენა, IaC, CI/CD უსაფრთხოება და DAST), სკანერის ნედლი გამომავალი მონაცემების შემცირება ხელმისაწვდომობის ანალიზის, ექსპლუატაციის შეფასებისა და ბიზნესზე გავლენის კონტექსტის თანმიმდევრული ფენების მეშვეობით. გამომავალი წარმოადგენს ნამდვილად ქმედითი აღმოჩენების პრიორიტეტულ რიგს და არა სკანერის მიერ აღმოჩენილი ყველაფრის ბრტყელ ჩამონათვალს.
AI AutoFix ქმნის კონტექსტის გათვალისწინებით, ენის სპეციფიკურ შესწორებებს, რომლებიც პირდაპირ მიეწოდება pull requestsდაფარვა SAST ადამიანის მიერ დაწერილ და ხელოვნური ინტელექტის მიერ გენერირებულ კოდში არსებული დასკვნები, დაუცველი დამოკიდებულებები და საიდუმლოებების გამჟღავნება. ცვლილებების ინტელექტის დარღვევა მიუთითებს დამოკიდებულებების განახლებებზე, რომლებიც შეიძლება არღვევდეს ბილდს PR-ის გახსნამდე. შესწორებების ახსნა-განმარტებები დეველოპერებს აძლევს კონტექსტს, რათა განიხილონ და დაამტკიცონ ცვლილებები თავდაჯერებულად და არა ბრმა ნდობით.
DevAI, Xygeni-ის IDE-ში ჩაშენებული ხელოვნური ინტელექტის უსაფრთხოების თანაპილოტი, კოდის დაწერისთანავე პირდაპირ დეველოპერის გარემოში აჩვენებს დახარისხების შედეგებს და AutoFix-ის შემოთავაზებებს. commit MCP სერვერის ინტეგრაცია ნიშნავს, რომ ხელოვნური ინტელექტის კოდირების ასისტენტებს შეუძლიათ უსაფრთხოების სკანირების განხორციელება, პრიორიტეტული დასკვნების მიღება და უსაფრთხო შესწორებების გამოყენება IDE-დან გაუსვლელად.
შედეგად: Xygeni-ის მომხმარებელი გუნდები იუწყებიან, რომ ათასობით ღია აღმოჩენიდან მართვად, პრიორიტეტულ რიგში გადადიან, ხოლო ხელით დამატებული შეცდომების გამოსწორებიდან ავტომატურ გამოსწორებაზე, რომელიც მასშტაბირდება კოდის ბაზასთან და არა პერსონალის რაოდენობასთან. თუ თქვენი უსაფრთხოების საკითხების შეფერხება უფრო სწრაფად იზრდება, ვიდრე თქვენს გუნდს შეუძლია მათი მოგვარება, პრობლემა ძალისხმევაში არ არის. პრობლემა იმაშია, რომ თქვენს მიერ გამოყენებული ინსტრუმენტები მათ გადასაჭრელად არ არის შექმნილი.

კითხვა-პასუხი
რამდენად შეუძლია ხელოვნურ ინტელექტს უსაფრთხოების დაგროვილი მასალების ხმაურის შემცირება?
გუნდები, რომლებიც იყენებენ ხელოვნური ინტელექტის ტრიაჟს ხელმისაწვდომობაზე დაფუძნებული პრიორიტეტულობით, როგორც წესი, ხედავენ სკანერის ნედლი გამომავალიდან 80–90%-ით შემცირებას ქმედით დასკვნებამდე. ზუსტი მაჩვენებელი დამოკიდებულია კოდის ბაზაზე, გამოყენებული სკანერების რაოდენობაზე და ტრიაჟის მოდელის სპეციფიკაზე, მაგრამ მიმართულების გავლენა თანმიმდევრულია: სტატიკური ანალიზის ინსტრუმენტებით მიღებული დასკვნების უმეტესობა კონტექსტში გამოსაყენებელი არ არის და ხელოვნური ინტელექტის ტრიაჟი ამოიცნობს და შლის მათ, სანამ ისინი დეველოპერების რიგში მოხვდებიან.
უსაფრთხოა თუ არა ხელოვნური ინტელექტის ავტომატური ფიქსის გამოყენება წარმოებაში? pipelines?
დიახ, შესაბამისი მმართველობით დანერგვის შემთხვევაში. AI AutoFix ყოველთვის უნდა მოიცავდეს ადამიანის მიერ განხილვას, სანამ ცვლილებები წარმოებაში გაერთიანდება; ღირებულება მდგომარეობს გამოსწორების ავტომატურად გენერირებაში და არა განხილვის პროცესის გვერდის ავლაში. მოძებნეთ ისეთი დანერგვები, რომლებიც მოიცავს გამოსწორების ახსნა-განმარტებებს, დარღვევების აღმოჩენის ფაქტორებს და ცვლილებების სრულ აუდიტის კვალს და მათ მიზეზებს.
რით განსხვავდება ავტომატური დაუცველობის გამოსწორება ხელით დაყენებისგან?
ხელით პატჩირებისთვის უსაფრთხოების ინჟინერმა ან დეველოპერმა უნდა წაიკითხოს აღმოჩენა, გაიგოს დაუცველობა, შეისწავლოს უსაფრთხო გამოსწორება, დანერგოს იგი, გამოსცადოს და წარადგინოს განსახილველად. ავტომატიზირებული დაუცველობის გამოსწორება ავტომატურად წარმოქმნის გამოსწორებას დაუცველობის ტიპის, ენის, ჩარჩოსა და კოდირების კონვენციების მიხედვით, რაც ამცირებს აღმოჩენიდან გამოსწორებამდე დროს დღეებიდან ან კვირებიდან საათებამდე ან წუთებამდე და მასშტაბირებას ახდენს მთელი აღმოჩენის რიგში, ერთდროულად ერთი პრობლემის ნაცვლად.
რა კავშირია ხმაურის შემცირებასა და უსაფრთხოების შეფერხებების შემცირებას შორის?
ეს ერთი და იგივე პრობლემის ორი მხარეა. ხმაური (დაბალი სიგნალი, არაექსპლუატირებადი ან ცრუ დადებითი შედეგები) ავსებს დაგროვილ ჩანაწერებს ისეთი ელემენტებით, რომლებიც დეველოპერის რიგში არასდროს უნდა მოხვედრილიყო. ხელოვნური ინტელექტის დახარისხების გზით ხმაურის შემცირება ამ ელემენტებს ზემოთ აშორებს, ამიტომ დაგროვილი ჩანაწერი მხოლოდ რეალურ რისკებს შეიცავს. შემდეგ AutoFix უფრო სწრაფად ხურავს ამ რეალურ რისკებს. კომბინაცია ერთდროულად ამცირებს დაგროვილ ჩანაწერებს ორივე მხრიდან.
