La priorisation des vulnérabilités basée sur les risques consiste à classer les anomalies de sécurité selon le risque réel qu'elles représentent pour votre application, et non selon leur score de gravité. Cette distinction est importante car la gravité est une propriété abstraite de la vulnérabilité, tandis que le risque est une propriété concrète de la vulnérabilité dans votre code : la fonction vulnérable est-elle appelée ? Est-elle exploitée publiquement ? À quel point le service affecté est-il exposé ? Et quelle serait la difficulté de la correction ? Une vulnérabilité CVSS de 9.8 dans une dépendance jamais utilisée par votre application est moins prioritaire qu'une vulnérabilité de 6.1 sur un point d'accès exposé à Internet et présentant une faille de sécurité publique. La gravité ne permet pas de faire cette distinction. Seule la priorisation basée sur les risques fournit ces signaux.
Qu’est-ce que la priorisation des vulnérabilités basée sur les risques ? Définition de travail #
Chaque analyseur que vous exécutez génère plus de résultats que votre équipe ne peut en traiter. Il ne s'agit pas d'un problème d'outillage, mais d'une simple question de calcul : la couverture augmente chaque année, tandis que les effectifs restent les mêmes. La question n'est plus « qu'avons-nous trouvé ? » depuis longtemps, mais « que faisons-nous lundi ? ».
Le triage basé sur la gravité apporte une réponse inadéquate. Il classe les incidents selon un nombre calculé sans aucune connaissance de votre système, ce qui revient à privilégier une catastrophe théorique plutôt qu'une catastrophe réelle. Les équipes s'en rendent vite compte et réagissent en ignorant la liste, ce qui est la pire des solutions puisque les trois éléments importants y figuraient.
Voici donc la définition de travail : La priorisation des vulnérabilités basée sur les risques est la pratique consistant à classer les résultats en utilisant des signaux contextuels concernant l'exploitabilité, l'accessibilité, l'exposition et le coût de la remédiation, de sorte que le haut de la file d'attente reflète ce qu'un attaquant pourrait réellement faire à ce système plutôt que ce qu'un organisme de notation a jugé possible en général.
On passe d'une caractéristique de la vulnérabilité elle-même à une caractéristique de la vulnérabilité et de votre application. Même CVE, priorité différente selon l'endroit où elle se situe.
Priorisation des vulnérabilités basée sur les risques : signification en quatre signaux #
Pour comprendre la hiérarchisation des vulnérabilités basée sur les risques, il est essentiel d'examiner les éléments qui contribuent à la gravité, car celle-ci ne disparaît pas pour autant. Elle devient un paramètre parmi d'autres.
- Atteint. La fonction vulnérable est-elle effectivement appelée depuis votre code ? Un package vulnérable ne constitue pas une application vulnérable. L’analyse d’accessibilité trace le chemin d’appel et l’affiche, ce qui permet de réduire considérablement la liste des dépendances critiques identifiées (par exemple, « nous avons trouvé 400 dépendances critiques ») à une liste beaucoup plus courte de celles qui sont effectivement exécutées.
- Exploitabilité. Est-ce que quelqu'un exploite cela dans le monde réel ? EPSS estime la probabilité d'exploitation au cours des 30 prochains jours, CISCatalogue des vulnérabilités exploitées connues Ces données recensent les vulnérabilités déjà utilisées en circulation, et la disponibilité publique des exploits indique le travail que devrait accomplir un attaquant. Il s'agit du point de vue de l'attaquant, et ces informations évoluent quotidiennement. CVSS La note reste inchangée depuis le jour de son attribution.
- Contexte commercial. Dans quelle mesure l'actif concerné est-il exposé et à quoi sert-il ? Un service de paiement en ligne et un outil de reporting interne présentant le même constat ne comportent pas le même niveau de risque, et seule votre organisation sait lequel est lequel.
- Coût de la remise en état. Quelle est la difficulté de la correction, et quels problèmes surviennent lors de son application ? Une simple mise à jour corrective et une mise à niveau majeure qui empêche la compilation sont deux choses différentes.cisdes ions, et une priorité qui ignore l'effort produit une file d'attente autour de laquelle personne ne peut planifier un sprint.
En résumé, la priorisation des vulnérabilités basée sur les risques signifie que la plupart des équipes convergent vers : Au lieu de vous demander à quel point cela pourrait être grave, commencez à vous demander à quel point la situation est grave ici, et combien il en coûte pour y mettre fin.
La différence concrète se manifeste dans les échanges entre les équipes de sécurité et d'ingénierie. Un ticket classé par niveau de gravité indique : « Ceci est critique, corrigez-le. » Un ticket classé par niveau de risque indique : « Ceci est accessible depuis votre contrôleur de processus, une faille de sécurité publique existe et la correction consiste en une mise à jour corrective. » Seul le premier type de ticket est traité sans discussion.
Il s'agit désormais de la position officielle, et non plus d'une simple bonne pratique. #
La priorisation des vulnérabilités basée sur les risques était autrefois l'alternative sophistiquée au correctif par niveau de gravité. Elle devient désormais la norme.
SSVC, développé par l'Institut de génie logiciel de Carnegie Mellon et adopté par CISA remplace le score par un decisArbre d'ions qui génère une action plutôt qu'un nombre, en fonction de l'état d'exploitation, de l'automatisation, de l'impact technique et de la prévalence de la mission. Et en juin 2026 CISUn émis Directive opérationnelle contraignante 26-04, remplaçant le BOD 22-01, qui ordonne aux agences fédérales de prioriser les mises à jour en utilisant l'exposition des actifs, le statut KEV, l'automatisation de l'exploitation et l'impact technique plutôt que la gravité seule.
Le message est clair pour tous les autres : l’agence qui tient à jour le catalogue officiel des vulnérabilités exploitées n’exige plus de ses propres agences qu’elles effectuent le tri par CVSS. Si vous continuez à le faire, vous utilisez une méthode obsolète, même pour ses propres responsables.
Comment fonctionne un entonnoir de priorisation ? #
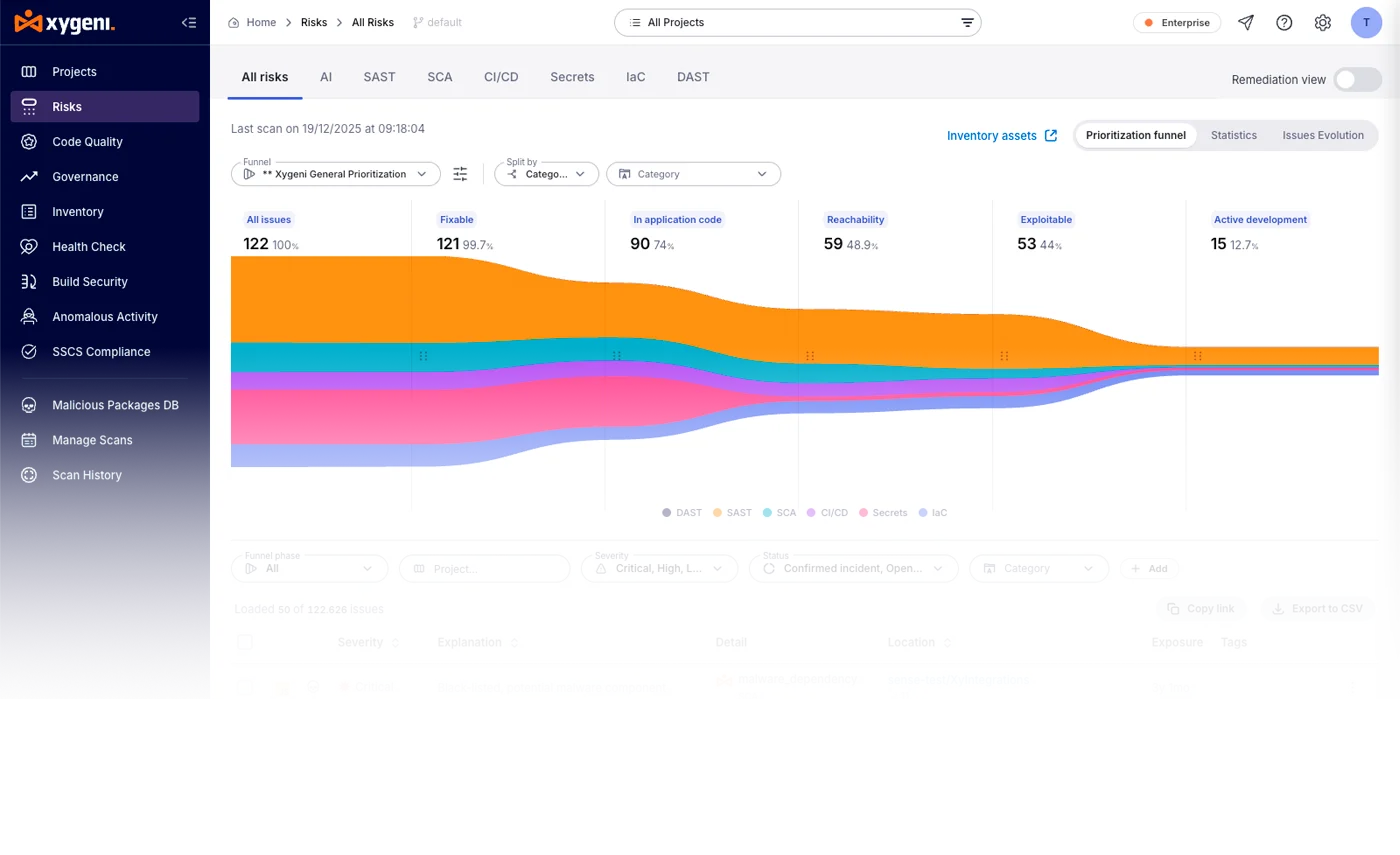
Les signaux pris isolément ne permettent pas d'établir de priorité. Ils doivent être enchaînés, afin que chacun restreigne le champ d'analyse du suivant. C'est cette chaîne qui… Xygéni appelle un entonnoir de priorisation.
Un entonnoir de traitement achemine les résultats à travers jusqu'à huit étapes ordonnées. Les étapes préconfigurées sont l'accessibilité, l'exploitabilité, la possibilité de correction, le résultat du triage par IA et l'urgence de la remédiation. Vous pouvez ajouter vos propres propriétés, telles que la criticité ou l'exposition pour l'entreprise. Les entonnoirs prêts à l'emploi couvrent chaque famille de risques, et vous pouvez filtrer n'importe quel tableau par phase de l'entonnoir pour voir les résultats validés à chaque étape. Une file d'attente de plusieurs centaines de résultats est réduite à la poignée d'éléments réels, accessibles, exploitables et justifiant ce sprint.
Deux de ces étapes proviennent de Triage de l'IAPour les anomalies détectées dans votre propre code, AI Triage analyse l'anomalie dans son contexte (flux d'exécution pour l'analyse statique ou données HTTP pour l'analyse statique de données) et renvoie un verdict : vrai positif, faux positif ou à examiner, ainsi qu'une urgence de correction (immédiate à en attente) et une complexité de correction (facile à difficile). Chaque verdict est accompagné de sa justification, chaque résultat est étiqueté comme généré par l'IA et votre équipe peut le modifier. Pour les anomalies provenant de sources ouvertes, la conception est volontairement différente : aucun verdict d'IA n'est généré, car accessibilité Elle remplit mieux cette fonction. Le triage par IA, quant à lui, apporte urgence et complexité.
L'élément le plus important pour les équipes disposant déjà d'une infrastructure : les mêmes processus de traitement et de tri s'appliquent aux résultats provenant d'autres scanners, et pas seulement de ceux de Xygeni. Les résultats issus de 40 outils et formats ou plus, y compris les données SARIF, sont dédupliqués et classés dans la même file d'attente. Vos outils actuels restent opérationnels. La priorisation n'est plus spécifique à chaque outil.
L'effet mesurable, selon les termes de clients qui l'ont fait: environ 90 % de temps en moins consacré à l'identification, à la priorisation et à l'attribution des constats de sécurité chez Banco Serfinanza, sur plus de 100 référentiels sous analyse continue, et une réduction de 90 % du temps de priorisation des vulnérabilités chez Fintonic.
Démo et apportez votre propre arriéré.
FAQ : Priorisation des vulnérabilités basée sur les risques, en bref #
Il est essentiel de classer les anomalies de sécurité en fonction des actions qu'un attaquant pourrait réellement entreprendre sur votre système, plutôt que selon le score de gravité associé à la vulnérabilité. Une même vulnérabilité (CVE) peut être critique pour une application et non pertinente pour une autre ; c'est la priorisation basée sur les risques qui permet de les distinguer.
Non, il est incomplet. CVSS décrit la vulnérabilité ; il n’a jamais été conçu pour décrire votre exposition à celle-ci. La priorisation basée sur les risques conserve la gravité comme indicateur et y ajoute ceux qui dépendent de votre environnement : l’accessibilité du code, l’exploitation en cours, le niveau d’exposition de la ressource et le coût de la correction.
Il s'agit de déterminer si la fonction vulnérable d'une dépendance est effectivement appelée par votre application. Si ce n'est pas le cas, la vulnérabilité est avérée mais non exploitable par votre code ; elle est donc reléguée au second plan plutôt que d'être ignorée. C'est le filtre le plus efficace pour les vulnérabilités open source, car la plupart des vulnérabilités de dépendances se trouvent dans du code qui n'est jamais exécuté.
Cela devrait être le cas, et c'est le test qu'il convient d'appliquer à toute plateforme prétendant le faire. Une priorisation qui ne classe que ses propres résultats aboutit à une file d'attente classée et plusieurs non classées, ce qui n'est pas une priorisation. Xygeni applique les mêmes entonnoirs et le même triage par IA aux résultats ingérés provenant d'autres outils.
Il ne s'agit pas du nombre de problèmes critiques ouverts. Il faut mesurer le délai entre le signalement d'un problème et sa prise en charge par un développeur, la proportion de problèmes attribués qui sont résolus plutôt que reportés, et le nombre de tickets contestés par les développeurs. La priorisation basée sur les risques est efficace lorsque les contestations cessent.