






アプリケーションセキュリティにおけるAutofixとは、開発ワークフロー内で脆弱性を自動的に検出し、手動による介入なしに修復するプロセスです。 現代のソフトウェアチームにとって、それは当然の次のステップのように思える。バックログは増え続け、リリースサイクルは短縮し続け、すべてのタスクを処理できる組織はほとんどない。 SAST 発見、依存関係の問題、秘密の漏洩、または IaC 設定ミスにより、完全に手動による修復キューに移行します。
しかし、落とし穴があります。チームは 脆弱性を修正する より速く、しかし、静かに回帰を引き起こしたり、依存関係を破壊したり、不安定性を生み出したりする自動化は望んでいません。 CI/CDその緊張関係は、現在、アプリケーションセキュリティにおける中心的な問題の一つとなっている。 OWASP 明示的に扱う CI/CD セキュリティ領域として独自の主要なリスクカテゴリを持ち、 NISTのセキュアソフトウェア開発フレームワーク 安全な開発手法を統合する必要があることを明確にする SDLC 端にボルトで固定するのではなく。
それが理由です 自動修正 これは単なる製品機能ではありません。運用モデルです。不適切に実装すると、ノイズ、リスク、ビルドの破損が発生します。適切に実装すると、検出と修復の間のギャップが縮まり、修正にかかる時間が短縮され、セキュリティがDevOpsのスピードに適合するようになります。このガイドでは、autofixが実際に何を意味するのかを見ていきます。 アプリセキュリティどのような場合に失敗するのか、安全な自動修復とはどのようなものであるべきか、そして開発者が実際に信頼できる方法でそれを実装するにはどうすればよいのか。
AppSecにおけるAutofixとは何ですか?
基本的には 自動修正 これは、ソフトウェアがセキュリティ上の問題を特定するだけでなく、解決策を提案、生成、または適用することを意味します。言い換えれば、このツールは「問題はここにある」から「解決策はここにある」へと移行するのです。
それは単純に聞こえるが、実際には非常に多様なワークフローを網羅している。
In SAST自動修正とは、通常、SQLインジェクション、クロスサイトスクリプティング、安全でない逆シリアル化パターン、脆弱な入力検証、または安全でない認証ロジックなどの脆弱性に対してコードレベルの変更を生成することを意味します。 SCA通常は、依存関係のアップグレードを推奨または適用したり、より安全なバージョンを固定したり、 pull requests パッケージをパッチ適用済みのリリースに移動する。 シークレットセキュリティ自動修正とは、単にフラグを立てるだけでなく、認証情報を失効させてローテーションすることを意味する場合があります。 IaCそれは、安全性の低いTerraform、Kubernetes、またはクラウド構成パターンを、より安全なデフォルト設定に書き換えることを意味する場合があります。
重要な違いは、自動修正とヒントは同じものではないということです。多くのセキュリティツールは一般的な修正案を提示できますが、開発者がすぐに利用できる変更を生成できるツールは少なく、さらに、その修正を実際の配信ワークフローで実行し、検証して、ソース管理におけるレビュー可能な変更として開発者に提示できるツールはごくわずかです。
その違いは重要です。なぜなら、現代のエンジニアリングチームはPDFやチケットで作業するのではなく、 pull requests方針、チェック、 pipelines.
従来の修復方法が規模拡大に向かない理由
自動修正の必要性は、まず痛ましい現実から始まる。それは、従来の修復プロセスが現代のソフトウェア配信には対応できないということだ。
ほとんどの組織は既に十分なスキャン機能を備えているが、解像度が不足している。静的解析、依存関係スキャン、シークレット検出、インフラストラクチャチェックによって、継続的に問題が発見される。一方、エンジニアリングチームは、新機能のリリース、リードタイムの短縮、本番環境の不安定化回避といったプレッシャーにさらされている。
その結果、発見と行動の間にギャップが生じる。
まず、単純なアラート量の問題があります。アプリケーションセキュリティプログラムが成熟するにつれて、検出されるアラートの数も増える傾向があります。しかし、これは必ずしもセキュリティの向上につながるわけではありません。多くの環境では、単に処理が滞るだけです。Xygeniの製品資料では、これをノイズと優先順位付けの問題として捉えており、この見方は業界全体の現実と一致しています。つまり、多くのプログラムが苦戦しているのは、検出だけでなく、優先順位付けなのです。
第二に、手動による修復は設計上時間がかかります。開発者は問題を読み、スキャナーの出力を解釈し、必要に応じて問題を再現し、修正を設計し、実装し、テストを実行し、 pull requestそして、レビューを待つ。これは、重大な問題が1件だけであれば許容できるかもしれない。しかし、中程度の深刻度の問題が数百件、依存関係のアップグレードが繰り返し発生したり、複数のリポジトリで機密情報が繰り返し漏洩したりする場合は、許容できない。
第三に、セキュリティとエンジニアリングは、しばしば異なる結果を最適化しようとします。セキュリティはリスクの低減を望み、エンジニアリングは変更を安全かつ予測可能な形で導入することを望んでいます。発見事項のフローが少ない場合は、この違いは管理可能です。しかし、チームが問題で溢れかえり、検証済みの発見事項を安全で摩擦の少ない修正に変換する仕組みが存在しない場合、この違いは深刻な問題となります。
まさにこうした状況において、自動化は必要不可欠に思えてくる。しかし、必要性があるからといって、自動化が安全であるとは限らない。
単純な自動修正の問題点
すべての自動修正が優れた自動修正とは限りません。実際、開発者がセキュリティ自動化に対して抱く多くの異論は、自動化そのものに対する異論ではなく、質の悪い自動化に対する異論なのです。
単純な自動修復エンジンには、通常、次の4つの問題のいずれかが存在します。
まず、あらゆる問題を等しく修正可能とみなす点が問題です。スキャナーは脆弱な依存関係を検出すると、単純に次のパッチ適用済みバージョンを提案します。コードエンジンは安全でないパターンを検出すると、既製の代替コードに置き換えます。これは単純なケースではうまくいくかもしれませんが、コードベース、アーキテクチャ、ランタイム、依存関係グラフなど、すべてが重要となる実際のシステムではすぐに破綻します。
2つ目は、実行コンテキストを無視している点です。単体では正しく見える修正でも、実際のコードパスに適用すると、無関係であったり、不十分であったり、リスクを伴う可能性があります。これが、悪用可能性シグナルが非常に重要な理由の1つです。FIRSTのEPSSは、cisなぜなら、脆弱性の深刻度だけでは、近い将来に悪用される可能性を判断する信頼できる指標とはならないからです。EPSSは、CVE(共通脆弱性識別子)に対する悪用活動の確率を日次で推定するため、チームは限られた修復能力を、攻撃される可能性の高いものに集中させることができます。
3つ目は、単純な自動修正では変更リスクを無視してしまうことです。これは特に、 SCA依存関係のアップグレードによってCVEが解消される場合でも、APIの非互換性、メソッドの削除、クラス名の変更、契約の変更、または微妙なランタイム動作の変更が生じる可能性があります。
4つ目は過剰自動化です。ツールが低価値な作業を大量に引き起こすと、 pull requestsその多くはテストに失敗したり、マージの摩擦を引き起こしたりするため、開発者はそれを無視するようになる。これは修正の加速ではなく、修正のスパムだ。
したがって、チームが是正措置を自動化すべきかどうかという問いではなく、どのような自動化が運用上の負担を増やすことなくリスクを軽減できるのかという問いこそが、真に重要な問いである。
破壊的な変更こそが真の信頼問題である
開発者が自動修正機能を信用していないと言うとき、彼らが意味するところは、非常に具体的なことが一つある。それは、自動修正機能が何かを壊さないとは信用できないということだ。
その信頼性の問題は、依存関係の解消において最も顕著に現れる。
脆弱性のあるパッケージにはパッチ適用済みのバージョンが用意されているかもしれませんが、だからといってアップグレードが安全とは限りません。パッチ適用済みのリリースでは、アプリケーションで使用しているメソッドが削除されたり、APIの名前が変更されたり、型契約が厳格化されたり、単体テストはパスするものの本番環境で不具合が発生するような動作変更が行われる可能性があります。多くのチームにとって、実際の修復コストはパッチの適用ではなく、その影響範囲を調査することにあります。
Javaの簡単な例を考えてみましょう。あるコードベースが、バージョン1.xには存在していたものの、バージョン2.xで削除された共通メソッドを持つライブラリに依存しているとします。
					// Before upgrade
MyService service = new MyService();
service.foo();
アップグレード後、 foo() もはや存在しません。脆弱性は解消されたかもしれませんが、ビルドが壊れています。
だからこそ、「修正版にアップデートするだけ」というのは、エンジニアリング戦略とは言えない。それは賭けだ。
OWASPの CI/CD 現代の配送方法にはガイダンスが関係するため pipelineは加速メカニズムと攻撃対象領域の両方です。不安定な変更や制御不能な変更を引き起こすセキュリティ制御は、 pipeline 行動は、一つの問題を解決するために別の問題を生み出す。 CI/CD 保護対策には、迅速な変更注入だけでなく、フロー制御、検証、およびポリシーの適用が必要です。
安全な自動修正機能は、こうした現実を尊重しなければならない。脆弱性が修正可能かどうかだけでなく、修正プログラムを導入しても、保護対象となるソフトウェアのライフサイクルを阻害しないかどうかも考慮する必要がある。
安全な自動車修理とはどのようなものか
安全な自動修正は「自動変更生成」ではありません。安全な自動修正とは 制御された自動修復.
それはつまり、5つのことを意味します。
まず、修正は状況を考慮したものでなければなりません。周囲のコード、フレームワークの慣例、データフロー、依存関係の動作を無視したセキュリティ対策の提案では不十分です。修正は脆弱性の種類だけでなく、アプリケーション全体に適合する必要があります。
第二に、修正はリスクを考慮したものでなければなりません。ここで修復リスク分析が重要になります。優れた自動修正システムは、変更を提案する前に、基本的なエンジニアリング上の疑問に答えることができなければなりません。つまり、この修復によってどのような問題が発生する可能性があるかということです。 重大な変更?
第三に、修正には優先順位を付ける必要があります。優れた自動修正プログラムは、一度にすべてを修正しようとはしません。脆弱性の悪用可能性、到達可能性、運用上の影響に基づいて修復を行います。これは、より広範な成熟したアプリケーションセキュリティプログラムの進化の方向性と一致しています。 CISAの既知の悪用された脆弱性カタログは、cis組織が搾取の証拠を是正措置に組み込むのを支援するcisイオン、つまり重症度スコアだけではない。
第四に、autofix は実際の配信ワークフロー内で実行されなければなりません。修復エンジンが機能しない場合 pull requestsチェック、ポリシー、テストなど、現代のチームがソフトウェアを提供する方法とは一致していません。
第五に、開発者は引き続き主導権を握る必要があります。開発者が承認した変更は、自動修正の弱点ではありません。むしろ、本番環境における自動化の信頼性を高めるための仕組みなのです。
言い換えれば、安全な修復には自動化だけでなく、制御も必要となる。
ナイーブな自動修正 vs 安全な自動修正
以下に、仕事を生み出す自動化と仕事をなくす自動化の実際的な違いを示します。
| 側面 | 素朴な自動修正 | セーフオートフィックス |
|---|---|---|
| 戦略を修正する | 脆弱性が検出され次第、汎用的な修正またはアップグレードを適用します。 | コード、依存関係の動作、ワークフローの検証に基づいて、状況に応じた修正を生成します。 |
| 依存関係の更新 | 変更影響分析なしで次のパッチ適用バージョンを推奨します | アップグレードパスを評価し、互換性を損なう変更がないかを確認してから、修正案を提案します。 |
| 優先順位付け | 重症度のみに基づいて作用する | 深刻度と悪用可能性、到達可能性、運用上の影響を組み合わせたもの |
| Pipeline 安全性 | ビルドやテストに失敗したプルリクエストを開く可能性があります | 修正を検証する CI/CD チェックと審査ゲート |
| 開発者の役割 | 開発者が自動化による影響を片付ける | 開発者は、安全で統合準備が整った修復提案をレビューする。 |
| 結果 | ノイズが増えれば、回帰も増え、信頼度も低下する。 | 修復の迅速化、リグレッションの減少、導入率の向上 |
この表から一つだけ教訓を得るとすれば、それは次の点です。 自動修正の品質は、そのコンテキストとコントロールの品質によって決まります。.
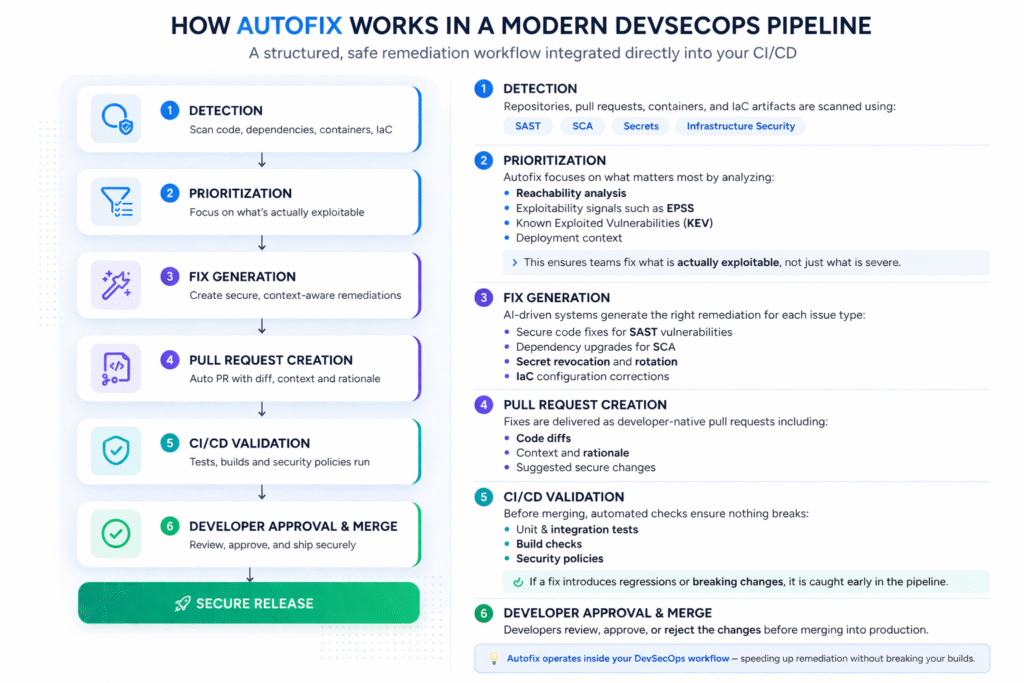
現代のDevSecOpsにおけるAutofixの仕組み Pipeline
成熟した環境では、 autofix は単一のアクションではありません。これは、構造化された修復ワークフローであり、 CI/CD.
手動による断片的な修正ではなく、現代の pipeline連続的な流れに従う:
現代のDevSecOpsにおけるAutofixの仕組み Pipeline
成熟した環境では、 autofix は単一のアクションではありません。これは、構造化された修復ワークフローであり、 CI/CD.
手動による断片的な修正ではなく、現代の pipeline連続的な流れに従う:
段階的な自動修正ワークフロー
- 検出
リポジトリ、 pull requests容器、または IaC 遺物はスキャンされ、 SAST, SCA機密情報、またはインフラストラクチャのチェック。 - 優先順位付け
すべての脆弱性が平等に扱われるわけではありません。自動修正システムは、以下の項目を優先します。- 到達可能性分析
- EPSSなどの悪用可能性シグナル
- 既知の悪用された脆弱性(KEV)
- 展開コンテキスト
- 修正生成
システムは、問題の種類に基づいて是正措置を生成します。- コード修正 SAST 脆弱性
- 依存関係のアップグレード SCA
- 秘密の取り消しとローテーション
- IaC 設定の修正
- Pull Request 創造
修正は、通常、開発者ネイティブのワークフローにパッケージ化され、 pull requests と:- コードの差分
- 背景と根拠
- 提案された変更点
- 検証 CI/CD
マージ前に、修正内容は自動的に検証されます。- 単体テストと統合テスト
- ビルドチェック
- セキュリティポリシー
- 開発者の承認とマージ
開発者は、変更内容を本番環境にマージする前に、変更内容をレビュー、承認、または却下します。
その結果、autofixは開発ライフサイクルを迂回するのではなく、その内部で動作する。
GitHub、GitLab、Azure DevOpsなどのプラットフォームとシームレスに統合し、 脆弱性対策は、独立したプロセスではなく、納品ワークフローの一部となる。
さまざまな脆弱性クラスに対応した自動修正機能
自動修正に関する議論で最もよくある間違いの一つは、すべての修正が同じように動作するとみなしてしまうことです。実際にはそうではありません。
自動修正 SAST
コードレベルの自動修正は、多くの人がこの概念に初めて触れる場面です。スキャナーがSQLインジェクション、反射型XSSシンク、または安全でない検証パターンを検出し、安全な代替案を提案します。修正内容がソースコードに反映され、他の変更と同様にレビューできるため、これは最も直感的な自動修正の形態と言えるでしょう。
Xygeniの製品資料では、AI AutoFixをこの分野において、開発者がすぐに使える修正プログラムを生成するコンテキスト認識型修復ツールとして位置付けています。 pull requests XSSやSQLインジェクションなどの問題に対して。製品の主張を超えて、その根底にあるメッセージは重要です。 SAST 自動修正機能は、ルールを認識するだけでなく、コードも認識する必要がある。
自動修正 SCA
依存関係の自動修正は、脆弱なパッケージが絶えず出現し、手動での依存関係の維持管理は拡張性に欠けるため、運用上は間違いなくより重要です。しかし、依存関係の更新は信頼を得るのが最も難しい部分でもあります。 重大な変更 最も苦痛になる。
信頼できる SCA したがって、自動修正機能は、パッチ適用済みのバージョンを見つけるだけでなく、アップグレードの安全性、影響範囲、互換性も評価する必要がある。
シークレットの自動修正
機密情報の修復は、コードの書き換えよりもむしろ封じ込めに重点が置かれます。公開されている機密情報が漏洩した場合、理想的な対応は、来週にローテーションするよう誰かに依頼するチケットを発行することではありません。理想的な対応は、即時の失効、置き換え、そして明確な追跡です。そのため、機密情報のセキュリティにおける自動修正は、コードの自動修正とは異なる場合が多いのです。重要なのは、スピードと確実性です。
自動修正 IaC
インフラストラクチャの設定ミスは、非常に繰り返し発生することが多い。そのため、自動化の対象として最適である。チームが standardTerraform、Kubernetes、ARM、またはCloudFormationの安全なパターンをサイズ設定すると、autofixはそれらのパターンをはるかに早い段階で強制できます。 pipelineNISTのSSDFは、各システムに安全なプラクティスを統合することに重点を置いています。 SDLC 実装はまさにここに当てはまります。セキュリティはワークフローに組み込まれている場合に最も強力であり、後の段階に先送りされるべきではありません。
Autofixでビルドが壊れるのを避ける方法
これはこのテーマの根底にある核心的な約束であり、直接的に取り上げる価値がある。
自動修正でビルドが壊れるのを避けるため、チームは他の本番環境向け変更と同様に、修正策を検証する必要があります。つまり、次のようになります。
- 変更を適用する前に、依存関係とコードへの影響を分析してください。
- 修正を検証する CI/CD テストとポリシー
- 爆発半径が大きい場所では自動スコープを制限する
- 重要な変更については開発者によるレビューが必要
- インパクトの大きいアップグレードには段階的な導入を用いる
だからこそ、修復リスク分析は非常に重要なのです。それは、「修復方法はあるのか?」という問いを、「これが最も安全で実行可能な修復方法なのか?」という問いに変えるからです。これは、はるかに優れた工学的問いと言えるでしょう。
これは、多くの自動化プログラムが失敗する原因でもある。それらのプログラムはスループットを最適化し、変更の安全性を無視してしまうのだ。開発者はすぐにそれに気づく。
それとは対照的に、信頼できる自動修正システムは、優秀なエンジニアリングチームが既に機能開発に適用している変更管理の規律、すなわちレビュー、テスト、検証、マージを尊重します。
Autofixを実装するためのベストプラクティス
自動修正プログラムを構築または成熟させる場合、目標は目新しさではなく、普及率を高めることであるべきです。自動修正は、後処理作業を発生させることなく、継続的に時間を節約できる場合に、チームは積極的に利用するようになります。
まずはポリシーから始めましょう。どの問題クラスを最初に自動化しても安全かを判断してください。 SAST 十分に理解されている書き換え、定義されたバージョン範囲内での依存関係の更新、または秘密の失効ワークフローを含むパターンは、初期段階で検討するのに適した候補となることが多い。
次に、範囲を絞り込みます。1回のリリースですべてを自動化しようとしないでください。まずは、共通していて確実性の高い問題に焦点を当てましょう。これは通常、広範囲にわたるものの混乱を招くような対策を展開するよりも、信頼構築においてより効果的な戦略となります。
修復を既存の開発者ワークフローに統合します。エンジニアリングチームが pull requests ブランチ保護機能と同様に、自動修正機能も備えているべきです。
成果を測定しましょう。適切な指標は「生成された修正数」だけではありません。マージ率、回帰率、時間短縮、誤検出の削減、修復までの時間などが重要です。
最後に、重要な箇所には人間の承認レイヤーを残しておきましょう。安全な自動修正機能は、開発者の判断を排除するものではありません。むしろ、反復作業を排除し、より価値の高いレビューに集中できるようにすることで、開発者の判断力を高めるものです。
検出から修復まで:ループを閉じる
従来のアプリケーションセキュリティツールにおける最大の弱点の1つは、プロセスが早すぎる段階で終了してしまうことです。問題が検出され、チケットが作成され、その後システムは待機状態になります。
それは閉じたループではありません。それは引き継ぎです。
最新のアプリケーションセキュリティプログラムは、検出から優先順位付け、修復までを、できる限り手作業による調整を少なくして実行できる必要があります。これこそが、自動修正の真の可能性です。自動修正は単に修復を高速化するだけでなく、修復が行われる場所、導入方法、そして反復作業を行う担当者を変革します。
これが、このテーマが技術的な側面だけでなく、商業的な側面でも重要である理由です。顧客はもはや検出精度だけを求めているわけではありません。未処理案件の目に見える削減と、問題の発見から解決までの迅速な移行を求めているのです。
Xygeniが安全な自動修復を実現する方法
Xygeniの資料では、同社の自動修復機能を「コンテキスト」「自動化」「配信統合」という3つのテーマを中心に位置づけている。
コード面では、 Xygeni AI SAST AutoFix は開発者向けの修正を生成し、危険なパターンを安全な代替案に置き換え、それらの修正を配信します。 pull requests 抽象的な推奨事項ではなく、XSSやSQLインジェクションなどの脆弱性を即座に修復し、開発者のワークフローに直接、セキュアコーディングのベストプラクティスを適用します。
しかし、Xygeni の自動修正機能は、 SAST。 また、含まれています シークレットオートフィックス漏洩した認証情報を検出し、事前に構築された機能を使用して自動的に失効させる playbooks AWS、GCP、GitLabなどのプラットフォーム全体で連携します。これにより、即座に脅威を封じ込めることができ、手動による対応の遅延をなくし、認証情報の悪用リスクを低減します。
依存関係の面では、 ザイジェニの SCA 自動修正 脆弱な依存関係の修正を生成し、大規模に適用することで、一括自動修復を可能にします。チームは自動パッチ適用をトリガーし、 pull requests アップグレードされたバージョンで、修復を直接統合します CI/CD pipeline配送を妨げることなく。
さらに、これらの機能は以下まで拡張されます。 コードとしてのインフラストラクチャ (IaC) (NAIST) と pipeline 構成を管理し、誤った構成やリスクの高いインフラストラクチャパターンも、同じ自動化されたワークフローの一部として修復されるようにします。
それが戦略的なポイントです。Safe autofixは単独で機能するわけではありません。 コード(SAST)、依存関係(SCA)、秘密、インフラストラクチャ(IaC)ソフトウェアサプライチェーン全体で一貫した修復を保証します。さらに、悪用可能性に基づく優先順位付け、依存関係グラフ分析、および CI/CD 検証を行うことで、修正は自動化されるだけでなく、安全で、関連性が高く、本番環境ですぐに使用できる状態になります。
簡単な回答:Autofixを使用して脆弱性を安全に修復するにはどうすればよいですか?
autofix を使用して脆弱性を安全に修復するには、チームはコンテキスト認識型の修正、悪用可能性に基づく優先順位付け、修復リスク分析、 CI/CD マージ前に検証と開発者の承認を行う。
それが短い答えです。
それ以下のレベルであれば自動化と言えるかもしれないが、開発者が本番環境で信頼できるような自動化ではない。
FAQ
AppSecにおけるautofixとは何ですか?
AppSecにおけるAutofixとは、コードの欠陥、脆弱な依存関係、漏洩した機密情報、インフラストラクチャの構成ミスといったセキュリティ上の問題に対する修復変更を自動的に生成し、配信する機能です。
自動修正によってビルドが壊れることはありますか?
はい。依存関係のアップグレードによって互換性のない変更が導入された場合、修正がアプリケーションのコンテキストを無視した場合、または検証なしで変更が適用された場合、自動修正によってビルドが破損する可能性があります。
脆弱性を自動的に修復する際に、回帰バグを発生させないようにするにはどうすればよいでしょうか?
管理されたワークフロー内で自動修正を使用する: 悪用可能性と到達可能性で優先順位を付け、修復リスクを分析し、変更を検証する CI/CD開発者の承認ステップを残しておく。
安全な自動修正と単純な自動修正の違いは何ですか?
安全な自動修正は、コンテキスト認識、リスク認識、 pipeline-認識。単純な自動修正は、互換性、実行時の影響、またはエンジニアリングのワークフローを理解せずに、変更を提案または適用するだけです。
AIによる自動修正は信頼できるのか?
そうである可能性はあるが、信頼性は検証とガバナンスに依存する。ガートナーは、AIベースのシステムを使用する組織に対して明確に推奨している。 code security AIオプティマイザーは、パフォーマンス、信頼性、コード品質に関連する問題を過剰に修正したり見落としたりする可能性があるため、アシスタントはバランス調整のための制御手段として、従来型のASTとコードレビューを引き続き使用しています。
最終的なポイント
自動修正機能は、もはやアプリケーションセキュリティの分野では目新しいものではありません。人員を増やしたり、開発スピードを落としたりすることなく、バックログを削減する必要のあるチームにとって、実用的な必須要件になりつつあります。
真の課題は、修復作業を自動化するかどうかではなく、その自動化がソフトウェアの実際の構築方法や出荷方法を尊重しているかどうかである。
自動修正戦略がコンテキスト、優先順位、検証を無視している場合、価値よりも摩擦が多くなります。開発者のワークフロー、修復リスク、検証を中心に設計されている場合、 CI/CD 制御ポイントを設けることで、セキュリティ上の成果とエンジニアリングのスピードの両方を大幅に向上させることができます。
それは standard 目指す価値がある。

著者について
共同創業者兼CTO
ファティマ Said AppSec、DevSecOps、および software supply chain security彼女は複雑なセキュリティシグナルを明確で実行可能なガイダンスに変換し、チームがより迅速に優先順位付けを行い、ノイズを減らし、より安全なコードを出荷できるよう支援します。
